Logs im Homelab: DNS, Caddy und Telefonie zentral auswerten
Wie ich DNS-, Caddy- und Telefon-Logs mit OpenTelemetry, Loki und Grafana zusammenführe – und was die Dashboards tatsächlich zeigen.
Ein DNS-Dashboard zeigt mir, ob eine Testabfrage funktioniert. Beim Reverse Proxy möchte ich wissen, welche Anfragen scheitern. Und wenn das Telefon etwas protokolliert, möchte ich dafür nicht erst eine Datei auf dem NAS durchsuchen.
In meinem Homelab lagen diese Informationen bisher an verschiedenen Stellen. Inzwischen laufen die Logs von Technitium DNS, Caddy und meiner Gigaset-Telefonanlage über einen OpenTelemetry Collector nach Loki. In Grafana gibt es dafür eigene Dashboards.
Damit bekommt mein bisheriges Monitoring eine weitere Perspektive: Zu den Messwerten kommen die konkreten Ereignisse.
Ein gemeinsamer Weg für unterschiedliche Quellen
Technitium sendet seine Protokolle über den Log Exporter als Syslog an den Collector. Die Telefonanlage schreibt ihre Meldungen auf mein QNAP. Caddy legt HTTP-Zugriffe und Betriebsmeldungen in getrennten JSON-Dateien ab.
Der Collector nimmt die Nachrichten entgegen und liest neue Einträge aus den eingebundenen Dateien. Er bereitet Zeitstempel, Schweregrade und weitere Felder auf und gibt die Daten an Loki weiter. Grafana stellt die Abfragen und Dashboards bereit.
Technitium DNS ── Syslog ────────────┐
Gigaset ── Logdatei auf dem QNAP ────┼── Collector ── Loki ── Grafana
Caddy ── JSON-Logdateien ────────────┘
Die Dateien sind für den Collector nur lesbar eingebunden. Seine Lesepositionen werden dauerhaft gespeichert. Bei der ersten Anbindung habe ich bewusst mit neuen Zeilen begonnen, statt alte Protokolle nachträglich zu importieren.
DNS: Rund 12.000 Einträge und eine Frage nach dem Kontext
Der DNS-Screenshot zeigt für einen ausgewählten Server innerhalb einer Stunde rund 12.000 Abfrage-Logs. Davon entfallen ungefähr 10.000 auf NOERROR und 2.000 auf NXDOMAIN. SERVFAIL steht bei null.
Das sind gerundete Anzeigen aus diesem Ausschnitt, keine Langzeitstatistik für den gesamten DNS-Cluster.
NXDOMAIN bedeutet, dass der angefragte DNS-Name nicht existiert. Die Zahl allein verrät mir noch nicht, weshalb ein Client diesen Namen abfragt oder ob daraus für den Nutzer ein Problem entsteht. Dafür brauche ich die betroffenen Namen, Clients und Zeitpunkte.
Genau hier helfen die Filter: Ich kann einen Server auswählen und die Suche auf einen Client oder einen Teil eines Domainnamens eingrenzen. Aus einer auffälligen Summe wird eine konkrete Frage: Wer fragt was ab?
Auch die Antwortzeiten bekommen zwei Perspektiven. Im gezeigten Zeitraum liegt der Median meist ungefähr zwischen 20 und 30 Millisekunden. Das P95 bewegt sich grob zwischen 70 und 135 Millisekunden. Dieses Perzentil beschreibt die Grenze, unter der etwa 95 Prozent der betrachteten Antwortzeiten liegen.
Die beiden Kurven zeigen, wie unterschiedlich die typische Anfrage und die langsameren Anfragen ausfallen. Sie erklären noch nicht die Ursache.
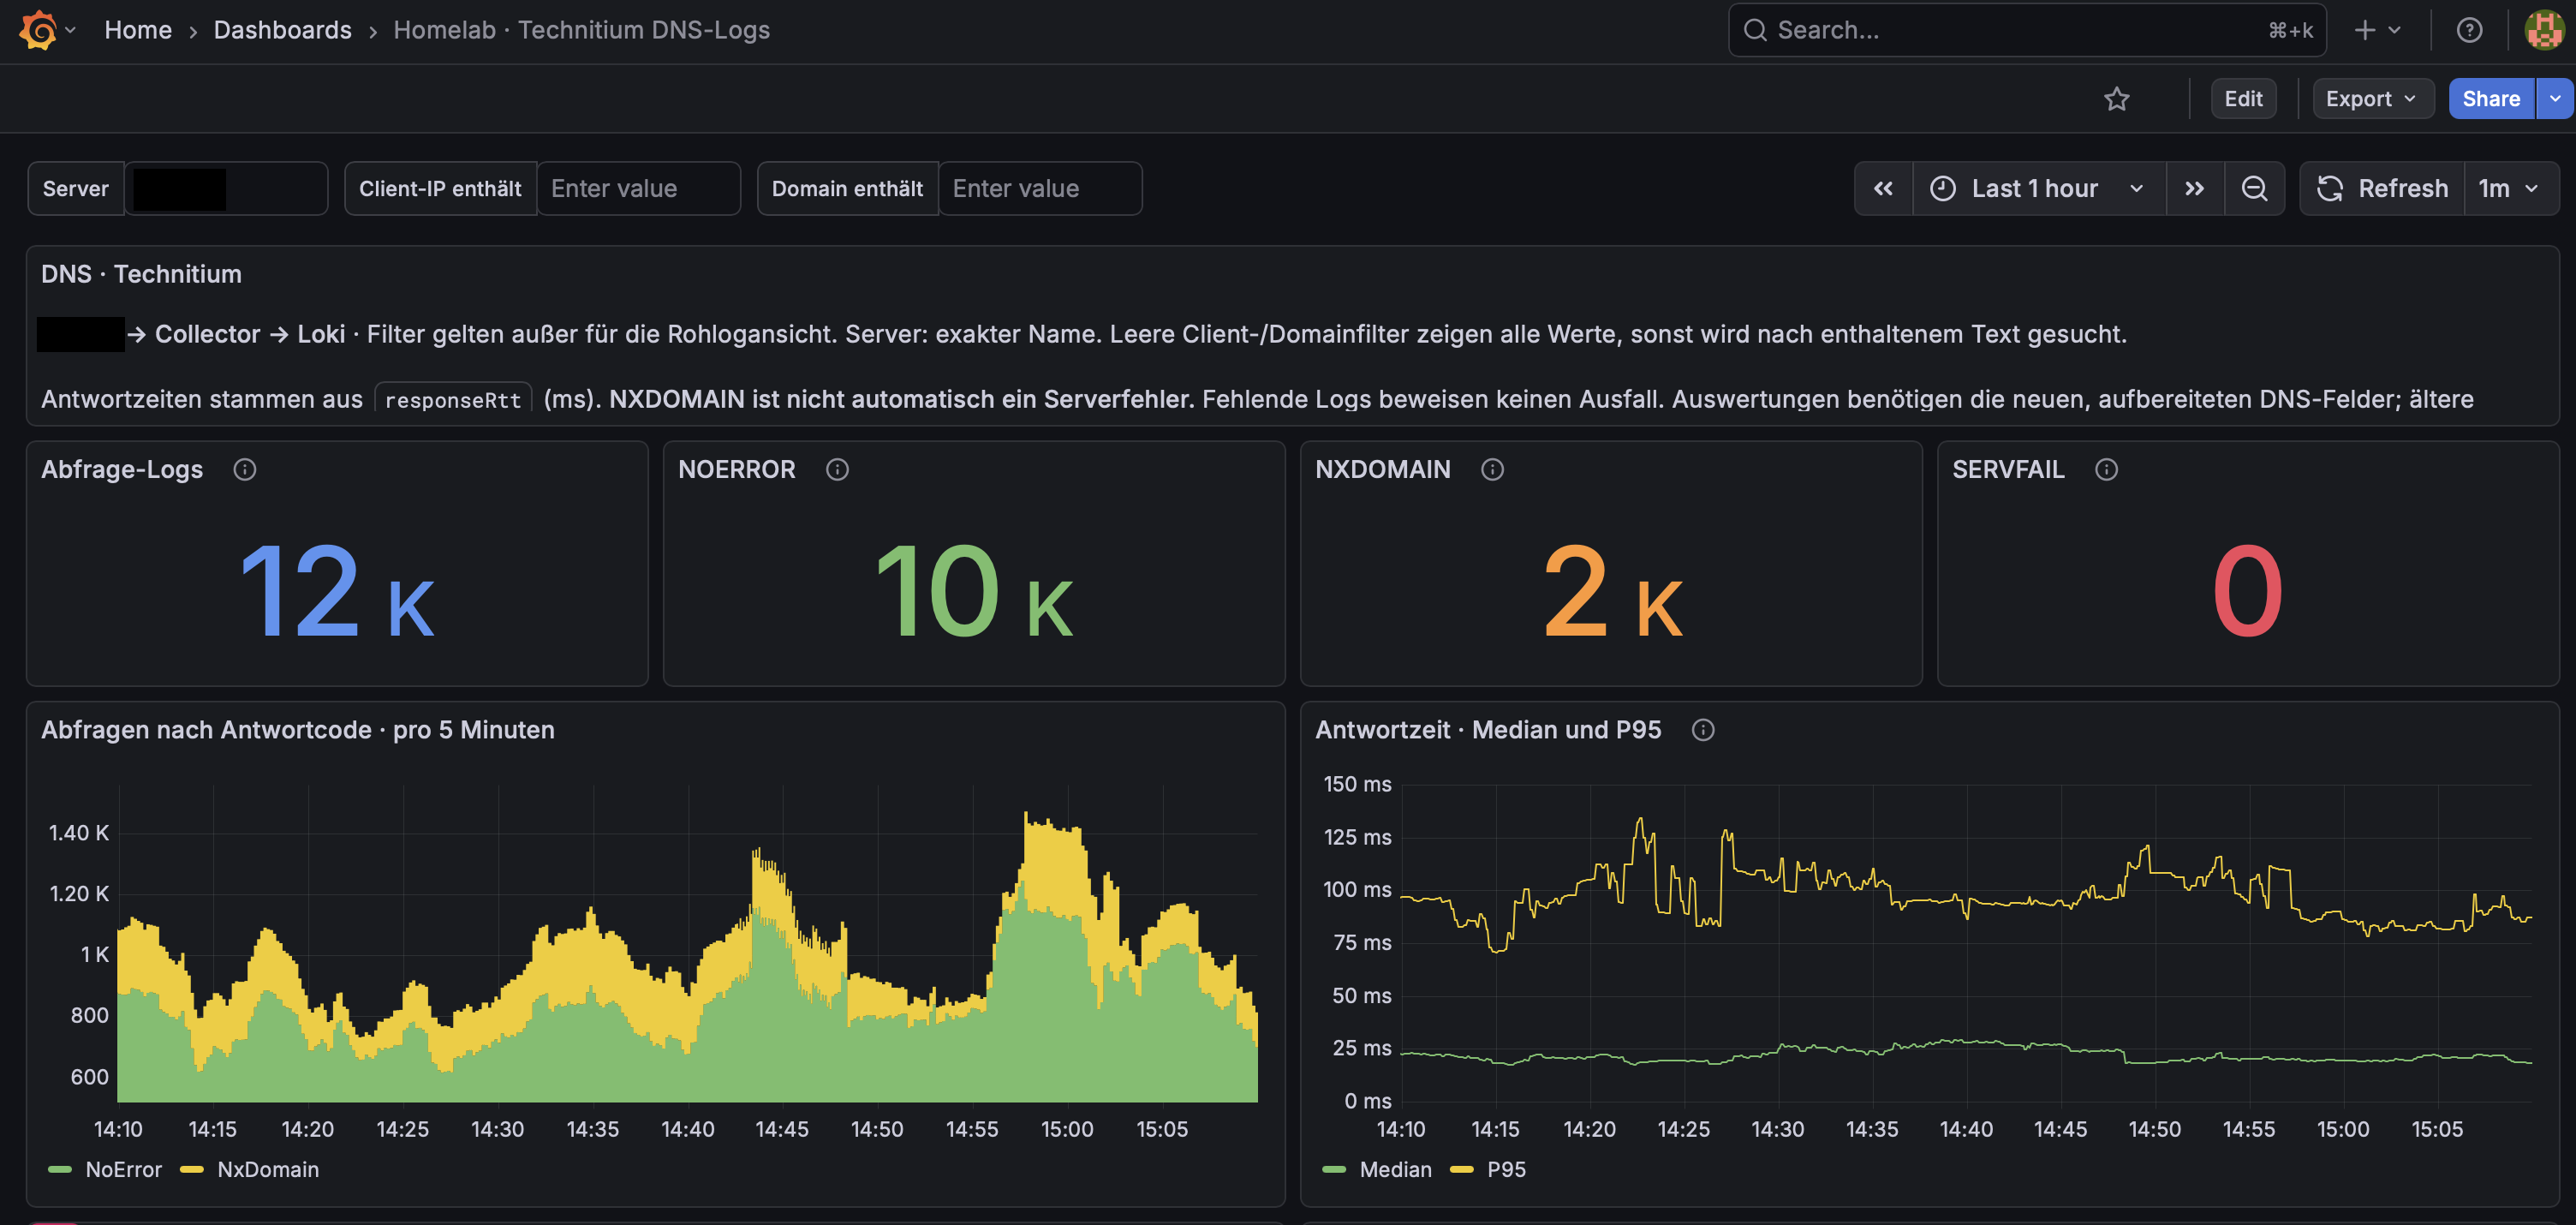
Technitium-Dashboard: Abfrage-Logs, Antwortcodes und Antwortzeiten für einen ausgewählten DNS-Server. Momentaufnahme vom 7. November 2026.
Caddy: Acht 4xx-Antworten sind ein Einstieg in die Suche
Beim Reverse Proxy interessiert mich, welche HTTP-Anfragen eintreffen, welche Statuscodes zurückkommen und wie lange die Bearbeitung dauert.
Der Screenshot zeigt 42 protokollierte Zugriffe, davon acht mit einem 4xx-Status. 5xx-Antworten und protokollierte Betriebsfehler stehen jeweils bei null. Im Verlauf tauchen unter anderem 400, 401 und 404 auf.
Diese acht Antworten haben deshalb noch keine gemeinsame Ursache. Eine nicht gefundene Adresse und eine Anfrage ohne passende Authentifizierung sind unterschiedliche Fälle. Die nächste Untersuchung führt zu den betroffenen Hosts, Pfaden und einzelnen Logeinträgen.
Auch bei der Dauer lohnt sich Genauigkeit: Das Dashboard zeigt die von Caddy protokollierte Gesamtdauer der Anfrage. Daraus kann ich nicht direkt die reine Verarbeitungszeit einer Anwendung hinter dem Proxy ablesen.
Im gewählten Stundenfenster sind erst am Ende Daten sichtbar. Der leere Bereich davor belegt für sich genommen keinen Ausfall. Gerade bei einer frisch eingerichteten Anbindung muss ich zuerst klären, ab wann überhaupt Logs gesammelt wurden.
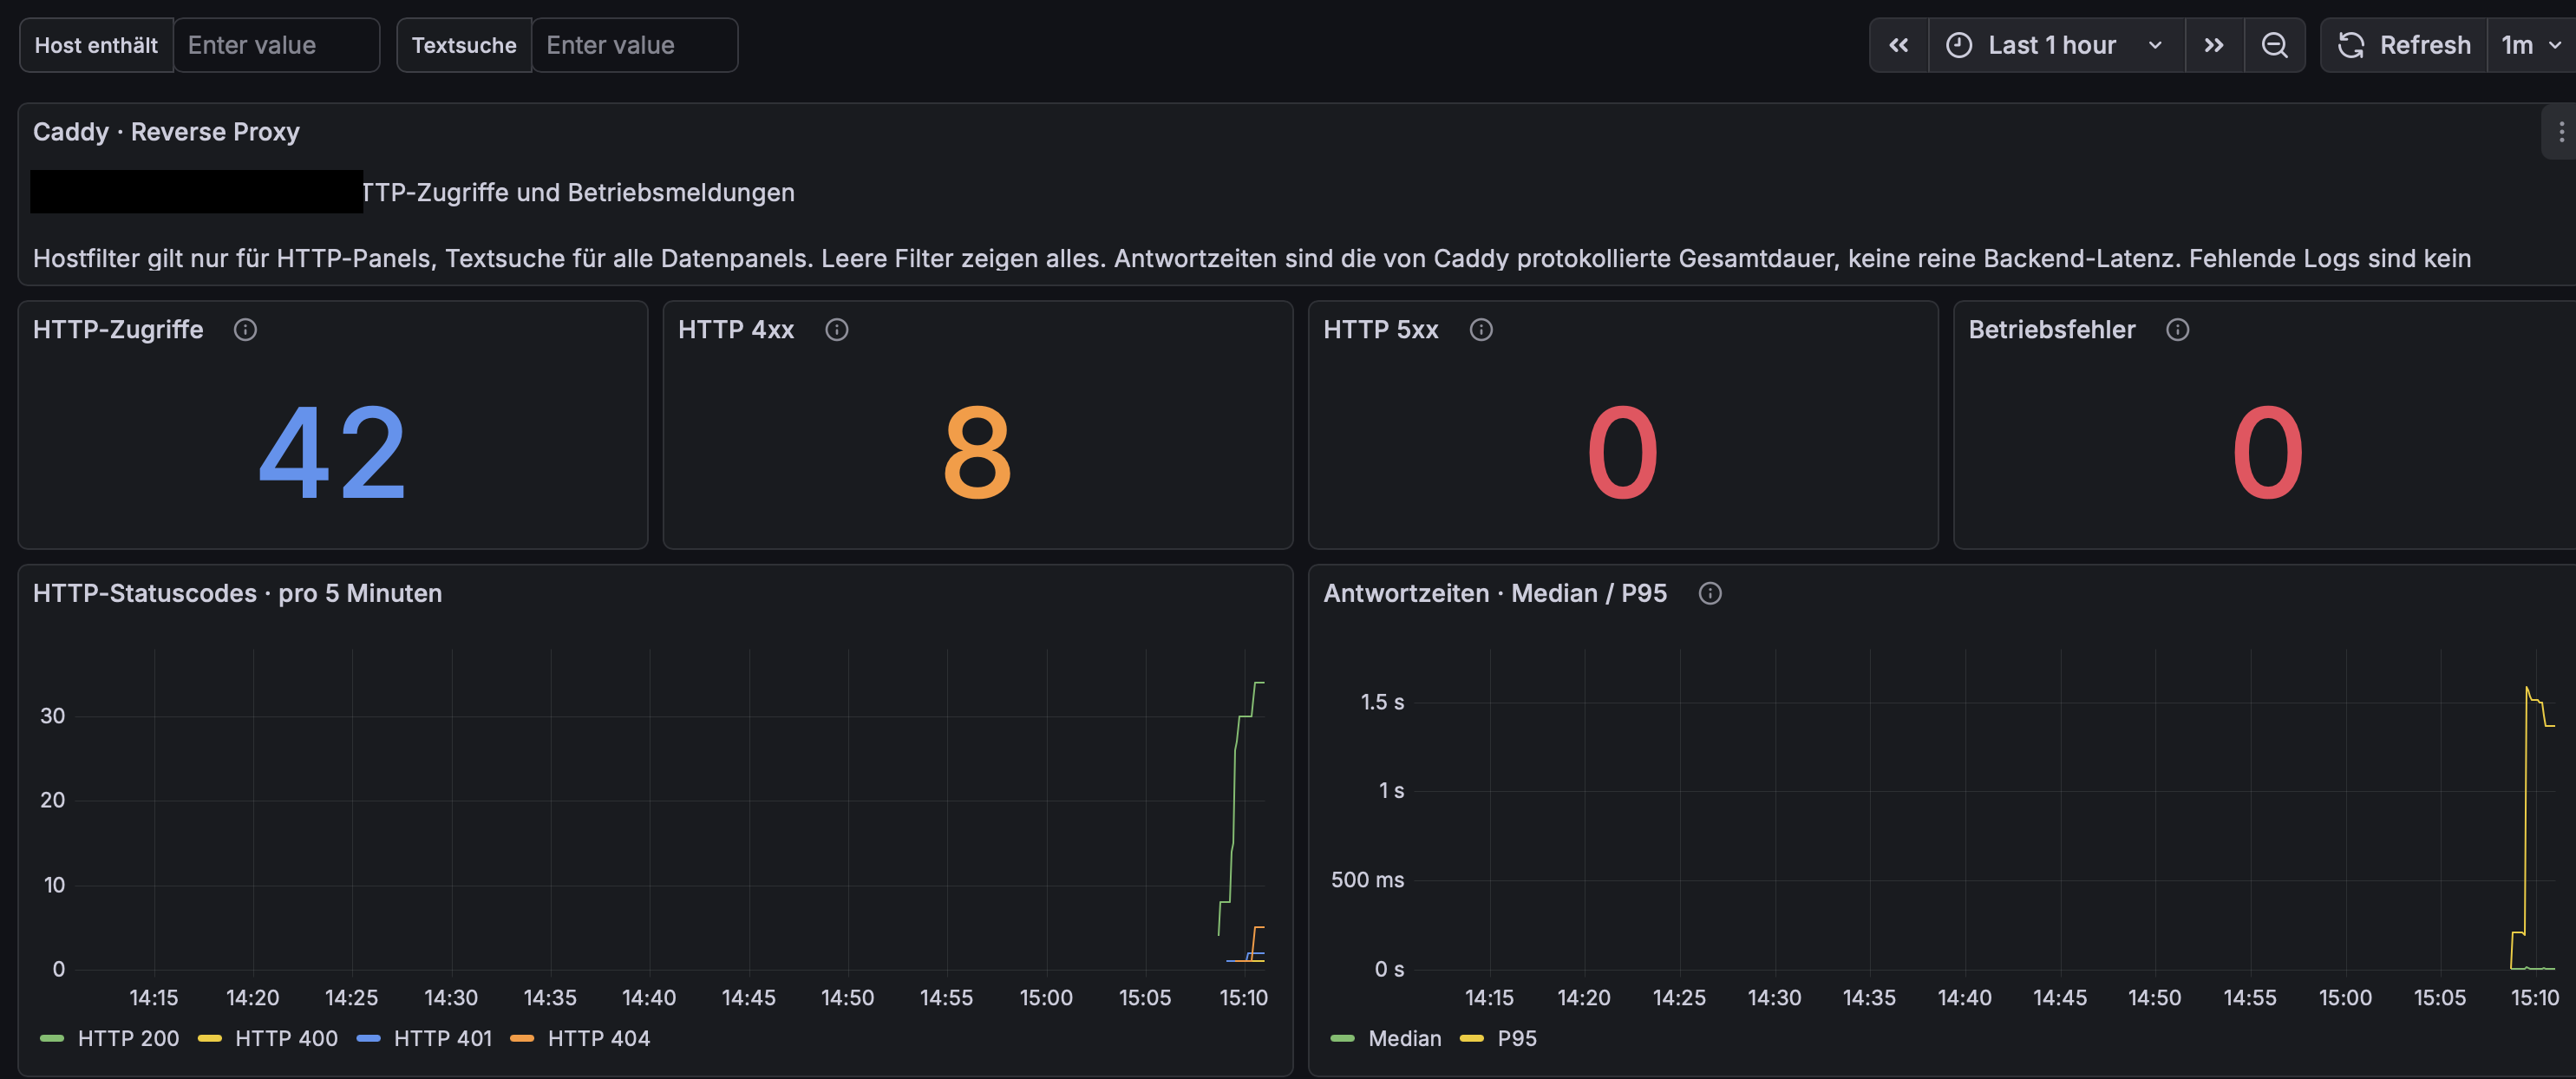
Caddy-Dashboard: 42 protokollierte HTTP-Zugriffe, acht 4xx-Antworten und keine erfassten 5xx-Antworten oder Betriebsfehler im ausgewählten Zeitraum.
Telefonie: Auch die unscheinbaren Geräte erzählen etwas
Die Telefonanlage war ein besonders praktischer Anwendungsfall. Ihre Logs lagen bereits auf dem NAS. Jetzt kann ich sie in Grafana nach Zeitraum und Text durchsuchen.
Der Screenshot umfasst sechs Stunden: 332 Einträge, keine als Fehler eingestuften Syslog-Meldungen, zwei Warnungen und 85 Meldungen zu DNS-TTL-Erneuerungen.
Die DNS-TTL beschreibt, wie lange eine zwischengespeicherte DNS-Antwort verwendet werden darf. Eine Meldung über den Ablauf dieser Zeit und eine erneute Abfrage ist zunächst ein Betriebsvorgang. Aus 85 solchen Meldungen werden nicht automatisch 85 Telefonieprobleme.
Für die Fehlersuche ist die zeitliche Sicht trotzdem hilfreich. Wenn ein Gesprächsproblem auftritt, kann ich gezielt nachsehen, welche Meldungen die Anlage zu diesem Zeitpunkt geschrieben hat. Ob tatsächlich eine Störung vorlag, muss ich anschließend mit dem beobachteten Verhalten abgleichen.
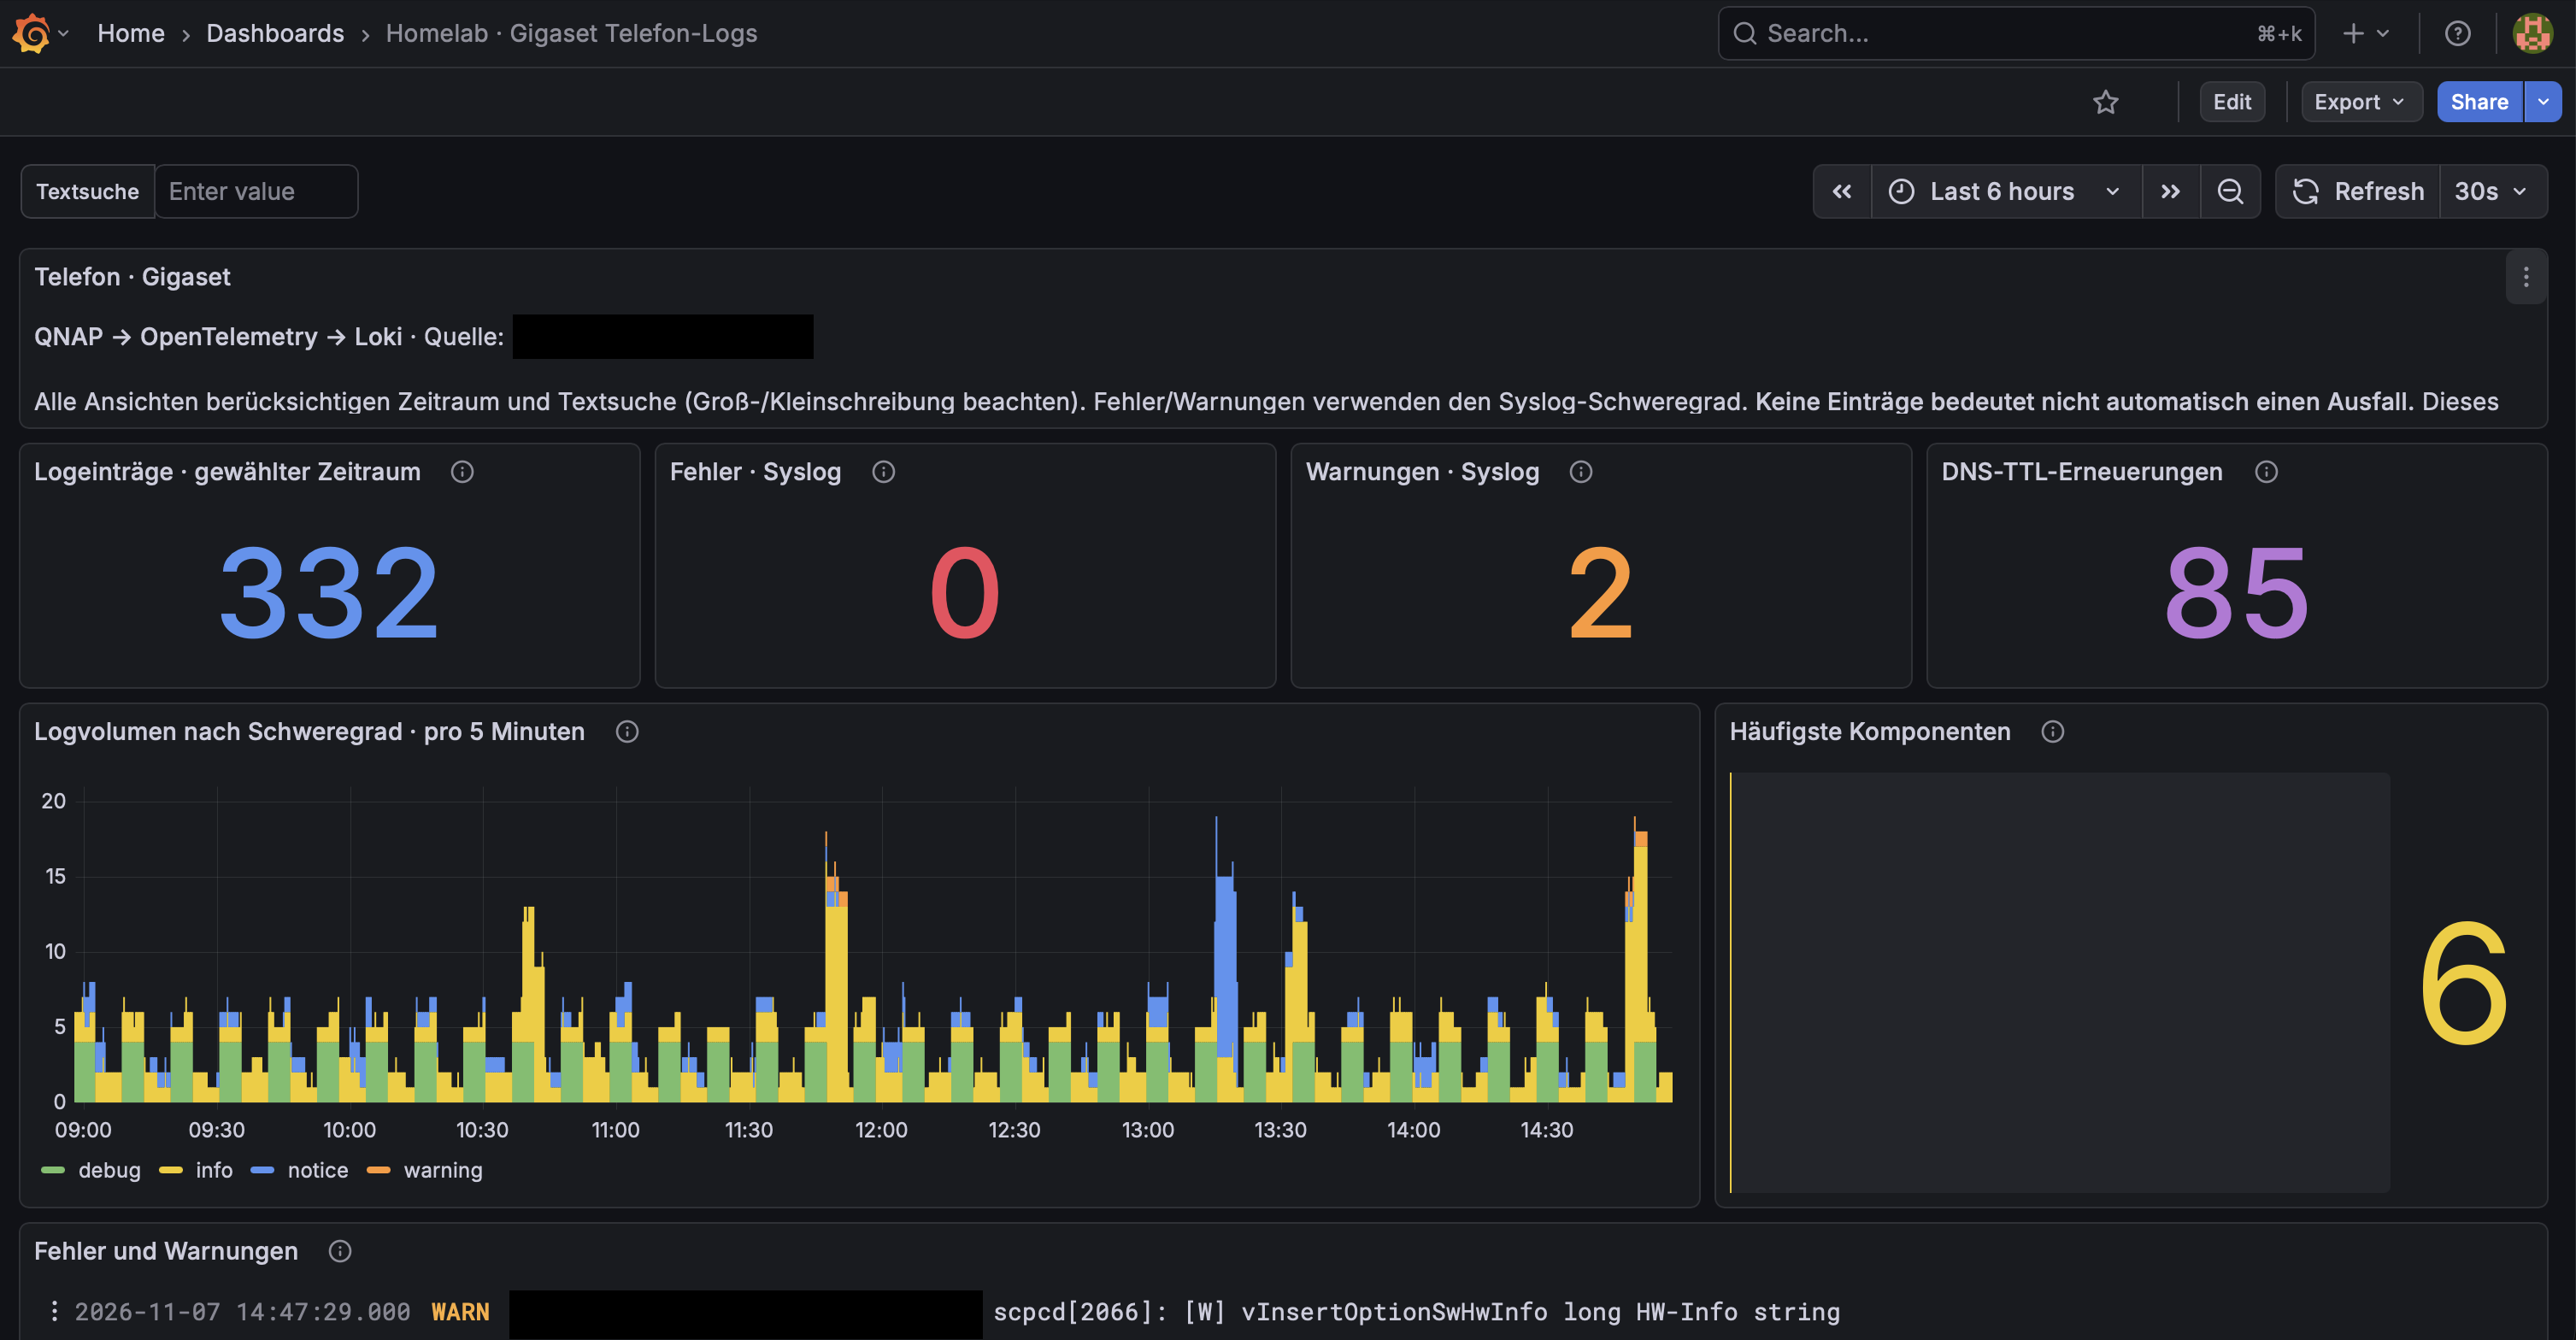
Gigaset-Dashboard: 332 Einträge über sechs Stunden, zwei Warnungen und 85 protokollierte DNS-TTL-Erneuerungen. Die Einstufung folgt dem Syslog-Schweregrad.
Die eigentliche Arbeit steckt in den Feldern
Logs zentral zu sammeln war nur der erste Schritt. Damit die Dashboards brauchbar werden, müssen die Informationen zuverlässig zugeordnet werden.
Bei Technitium gehören dazu Servername, Client, angefragter Name, Antwortcode und Antwortzeit. Beide DNS-Server verwenden denselben Empfänger und bleiben als unterschiedliche Quellen erkennbar.
Bei Caddy kommen viele Informationen bereits als JSON an. Bei der Telefonanlage müssen Zeitstempel und Schweregrad aus dem Syslog-Format übernommen werden.
Erst diese Aufbereitung macht gezielte Filter und Auswertungen möglich. Eine Textzeile lässt sich finden. Mit passenden Feldern lässt sie sich auch sinnvoll mit anderen Einträgen vergleichen.
Was damit erreicht ist – und was offenbleibt
Die Logs kommen in Grafana an. Die drei Screenshots zeigen befüllte Dashboards, und das Caddy-Dashboard ist geprüft. Damit steht eine zentrale Sicht für diese Quellen.
Mein bestehendes Monitoring mit aktiven Prüfungen bleibt trotzdem wichtig. Es stellt gezielt eine Anfrage und prüft die Reaktion. Logs zeigen dagegen, was die angebundenen Systeme tatsächlich protokolliert haben. Keine neuen Einträge können Ruhe bedeuten, aber auch eine unterbrochene Übertragung.
Auch die Sammlung selbst hat Grenzen. Collector und Loki laufen in meinem QNAP-Umfeld. Ein Ausfall dieses Systems betrifft ebenfalls die Sicht auf die Logs. Gespeicherte Lesepositionen erleichtern das Weiterlesen nach einem Neustart, garantieren aber allein noch keine verlustfreie Zustellung. Die Aufbewahrung in Loki ist in meinem Aufbau auf sieben Tage begrenzt.
Aus den neuen Dashboards leite ich deshalb noch keine getestete Alarmierung ab. Ein nächster Schritt wäre, ausgewählte Fehler gezielt auszulösen und zu prüfen, ob sie vollständig und verständlich sichtbar werden.
Für den Alltag ist bereits etwas gewonnen: Ich kann bei einer Auffälligkeit an einer zentralen Stelle anfangen und von einer Zahl zu den konkreten Ereignissen wechseln.
Welche Logquelle hat euch im eigenen Homelab schon einmal die entscheidende Erklärung geliefert?
Eigene Screenshots vom 7. November 2026. Interne Angaben wurden deckend geschwärzt.