Wem gehört das Wissen? – Abhängigkeit von AI-Anbietern vermeiden
Warum Unternehmen das Wissen über Infrastruktur, Anwendungen und Ende-zu-Ende-Services auch in AI-gestützten Betriebsmodellen selbst kontrollieren müssen.
Ein Kundenauftrag wurde angenommen. Das Zeitfenster für die Aktivierung ist abgelaufen. Der Service wartet noch immer auf seine Aktivierung.
Das Portal antwortet. Die Health Checks der Anwendungen sind erfolgreich. Cloud- und Rechenzentrums-Dashboards zeigen gesunde Plattformen. Beide Firewall-Umgebungen sind betriebsbereit.
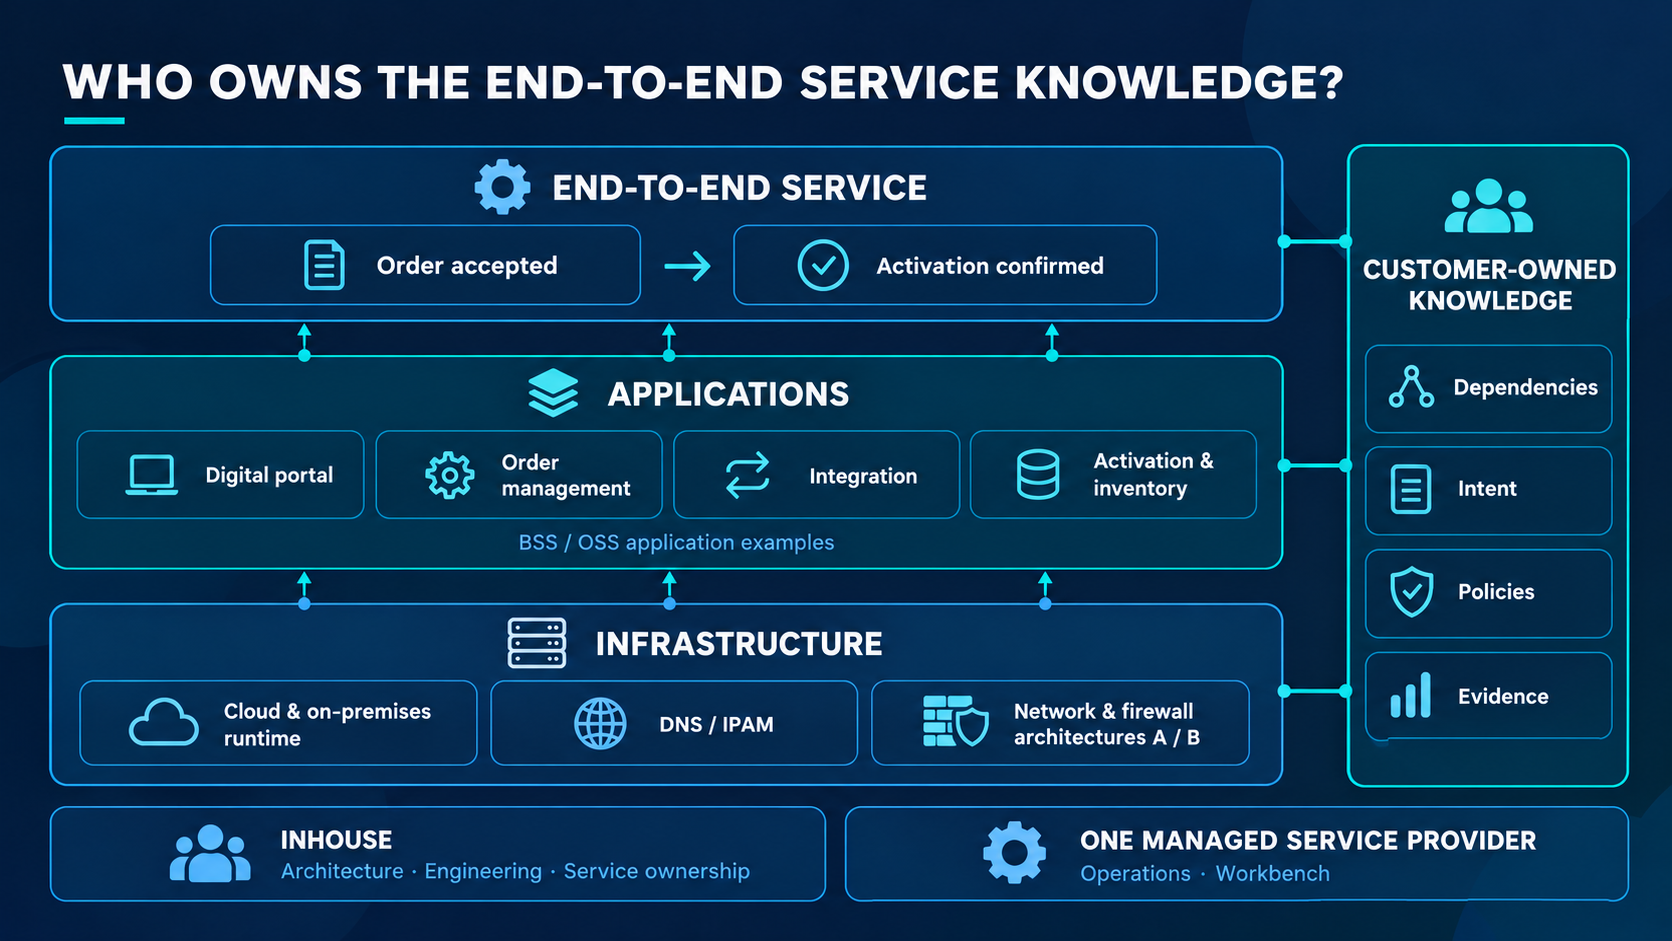
In dieser beispielhaften Telco-Umgebung betreibt ein Managed Service Provider die hybride IT-Umgebung und die dazugehörige Workbench. Zwei herstellerspezifische Firewall-Architekturen sind Teil dieser Infrastruktur. Architektur und Engineering bleiben überwiegend im Unternehmen.
Um das ausgebliebene Ergebnis zu verstehen, ist ein Blick über alle beteiligten Systeme hinweg erforderlich: Welche Anwendungen verarbeiten den Auftrag, von welchen Schnittstellen hängen sie ab und welche Infrastruktur ermöglicht diese Interaktionen?
Je stärker AI Agents diesen Gesamtblick zusammenstellen, desto wichtiger wird die Eigentumsfrage: Wer behält das Wissen, das Infrastruktur, Anwendungen und den Ende-zu-Ende-Service miteinander verbindet?
1. Gesunde Plattformen, unvollständiger Service
In diesem Beispiel reicht die Ende-zu-Ende-Grenze von einem angenommenen Kundenauftrag bis zur bestätigten Aktivierung innerhalb eines vereinbarten Zeitfensters. Eine erfolgreiche Antwort des Portals markiert dabei nur den Anfang.
Der Prozess umfasst Anwendungen aus dem Bereich der Business Support Systems (BSS), etwa Kunden- und Produktauftragsmanagement, sowie aus dem Bereich der Operations Support Systems (OSS), beispielsweise Service-Aktivierung und Ressourcen-Inventar. BSS und OSS sind funktionale Domänen. Ihre Komponenten können in der Cloud oder im eigenen Rechenzentrum betrieben werden.
Ein Auftrag kann mehrere API-Aufrufe, Nachrichten und Verarbeitungsschritte auslösen. Diese Interaktionen hängen von Netzwerkerreichbarkeit, Identitäten, Laufzeitdiensten und Sicherheitskontrollen ab. Sie bilden jedoch keine einzige durchgehende Netzwerkverbindung.
Eine Plattform kann verfügbar bleiben, obwohl eine bestimmte Anwendungsabhängigkeit ausfällt. Das Monitoring muss deshalb den Zustand einzelner Komponenten mit dem Fortschritt und Ergebnis des vollständigen Prozesses verbinden.
2. Infrastruktur, Anwendungen und Service-Ergebnisse verbinden
Drei Sichtweisen müssen miteinander verbunden werden.
Die Infrastruktursicht beschreibt Cloud- und On-Premises-Laufzeitumgebungen, Netzwerkpfade, DNS, Adresszuweisung und die Durchsetzung von Sicherheitsvorgaben.
Die Anwendungssicht beschreibt Komponenten, Schnittstellen, Nachrichtenaustausch, Identitäten und Abhängigkeiten.
Die Service-Sicht definiert das erwartete Ergebnis, dessen Verantwortlichen, die zulässige Bearbeitungszeit und die Nachweise, die für eine erfolgreiche Bestätigung erforderlich sind.
Beide Firewall-Architekturen gehören zur Infrastruktursicht. Ihre Objektmodelle, Policy-Semantik und APIs können sich unterscheiden und dennoch zu einem gemeinsamen Ende-zu-Ende-Design beitragen. Ein einzelner Provider kann ihren Betrieb koordinieren, sofern diese Unterschiede im gemeinsamen Modell ausdrücklich sichtbar bleiben.
Die Verbindung dieser drei Sichtweisen ermöglicht es einem Engineer, zu bewerten, welche Services von einer geplanten Infrastrukturänderung betroffen sein könnten. Gleichzeitig kann der Betrieb von einer verzögerten Aktivierung ausgehend zu der betroffenen Anwendungsabhängigkeit und den zugrunde liegenden Ressourcen zurückarbeiten.
3. Das strategische Gut ist das Service-Abhängigkeitsmodell
Das Unternehmen benötigt ein nutzbares Modell dieser Zusammenhänge. Es sollte erklären:
- welche Anwendungsfunktionen ein definiertes Service-Ergebnis liefern,
- welche APIs, Events und technischen Identitäten sie verbinden,
- wo Workloads ausgeführt werden und von welchen Netzwerk- und Sicherheitskontrollen sie abhängen,
- wer für Service, Anwendungen, Schnittstellen und Ausnahmen verantwortlich ist,
- warum eine Kommunikationsbeziehung erforderlich ist,
- und welche Tests und Beobachtungen nachweisen, dass sie funktioniert.
Dieses Modell kann auf mehrere führende Systeme zurückgreifen. Jede Beziehung benötigt eine Quelle, eine Version oder einen Beobachtungszeitpunkt sowie eine Möglichkeit, ein freigegebenes Design von beobachtetem Produktionsverhalten zu unterscheiden.
Ein Konfigurationsexport enthält wertvolle Implementierungsdetails. Das Abhängigkeitsmodell ergänzt den Kontext, der erforderlich ist, um deren Auswirkungen auf Anwendungen und Services zu verstehen.
Das Telco-Unternehmen sollte dieses Modell kontrollieren und sowohl die Rechte als auch die praktische Fähigkeit behalten, es außerhalb der Workbench des Providers einzusehen, zu aktualisieren und weiterzuverwenden.
4. IPAM verbindet Netzwerkadressen mit Anwendungskontext
IP Address Management liefert Adresszuweisungen, Präfixe und zugehörige Netzwerkmetadaten. Diese Informationen werden wertvoller, wenn sie mit Workload-, Anwendungs- und Service-Kennungen verknüpft sind.
Wird beispielsweise ein Workload in ein neues Subnetz verschoben, kann seine logische Rolle unverändert bleiben, obwohl sich seine technische Adresse ändert. DNS, Cloud-Inventar, IPAM und Firewall-Objekte müssen mit der beabsichtigten Anwendungsbeziehung abgeglichen werden.
IPAM kann diese Beziehung nicht allein herstellen. Laufzeit-Inventare beschreiben die bereitgestellten Workloads, DNS übernimmt die Namensauflösung und Anwendungs- sowie Service-Inventare liefern Zweck und Verantwortlichkeit. Wenn NAT eingesetzt wird, müssen auch die entsprechenden Zuordnungen nachvollziehbar sein.
Die Wissensschicht sollte diese Quellen verbinden und widersprüchliche oder veraltete Informationen sichtbar machen. Dadurch erhalten Engineers und Agents eine Grundlage, um zu prüfen, ob die bereitgestellte Konnektivität weiterhin den beabsichtigten Service unterstützt.
5. Architektur und Engineering bleiben intern
Die verbleibende interne Organisation benötigt die Kompetenz, dieses Modell zu entwerfen, seine Annahmen kritisch zu prüfen und seine Umsetzung zu verifizieren.
Architektur und Engineering bleiben überwiegend im Unternehmen. Sie werden von Application Ownern und einem benannten Ende-zu-Ende-Service-Owner unterstützt. Zu ihren Aufgaben gehören:
- Zielarchitektur und Modelle der Anwendungsabhängigkeiten,
- Service-Ergebnisse und Abnahmekriterien,
- Sicherheitszonen, Connectivity Intent und Identity Governance,
- Engineering Patterns und die Abnahme von Hersteller-Adaptern,
- Regeln für die Datenqualität der gemeinsamen Wissensschicht,
- Autonomiegrenzen, Ausnahmen und Risikoentscheidungen,
- sowie die Tests zur Bewertung von Änderungsauswirkungen und Portabilität.
Der Service Owner definiert, was eine erfolgreiche Leistungserbringung bedeutet. Application Owner liefern Schnittstellenverträge und Nachweise aus den Anwendungen. Infrastruktur-Engineers stellen sicher, dass die technischen Grundlagen diese Anforderungen unterstützen.
Der Provider kann spezialisiertes Fachwissen einbringen. Interne Teams benötigen dennoch genügend praktisches Verständnis, um eine Empfehlung zu bewerten, eine umstrittene Abhängigkeit zu klären und einen Providerwechsel zu steuern. Entscheidungsbefugnis setzt diese Kompetenz voraus.
6. Betrieb und Workbench können ausgelagert werden
Ein Provider kann die Umgebung und die AI-gestützte Workbench betreiben. Dabei koordiniert er Monitoring, Diagnose, Routinewartung und freigegebene Änderungen über die relevanten Plattformen hinweg.
Dazu gehören die Korrelation von Anwendungs- und Infrastrukturereignissen, die Pflege von Netzwerkobjekten nach den Regeln des Kunden, die Ausführung getesteter Automatisierung, die Durchführung von Rollbacks sowie die Sammlung operativer Nachweise. Beide Firewall-Architekturen bleiben unter derselben operativen Steuerung.
Die Leistung des Providers sollte anhand vereinbarter Prüfungen auf Infrastruktur-, Anwendungs- und Service-Ebene gemessen werden. Eine erfolgreich ausgerollte Konfiguration ist ein Kontrollpunkt. Die betroffene Anwendungsinteraktion und das Service-Ergebnis benötigen jeweils eine eigene Verifikation.
Eine gemeinsame Betriebsoberfläche vereinfacht die Koordination. Ihre Service-Zuordnungen, Diagnosekontexte und Entscheidungsprotokolle müssen jedoch auch für die Engineering-Organisation des Kunden zugänglich und wiederverwendbar bleiben.
7. AI Agents sollen Engineering und Betrieb stärken
AI Agents können beiden Teams helfen, mit demselben Service-Modell zu arbeiten. Ihr Nutzen hängt von der Qualität des verfügbaren Kontexts, den verwendbaren Werkzeugen und den Nachweisen für ihre Schlussfolgerungen ab.
Engineering Agents können interne Architekten und Engineers dabei unterstützen, die Beziehungen zwischen Infrastruktur, Anwendungen und Service-Ergebnissen zu pflegen. Sie können beabsichtigte Abhängigkeiten mit bereitgestellten Konfigurationen und beobachteter Kommunikation vergleichen, unerklärte Änderungen hervorheben und Services identifizieren, die möglicherweise von einer geplanten Migration betroffen sind.
Wenn ein Workload zwischen Cloud- und On-Premises-Umgebungen verschoben wird, könnte ein Agent die relevanten Schnittstellenverträge, DNS- und IPAM-Einträge, Identitätsanforderungen, Netzwerk-Policies und Service-Tests zusammenstellen. Engineers können anschließend den vollständigen Satz von Abhängigkeiten bewerten. Sofern geeignete Testumgebungen oder Simulationswerkzeuge vorhanden sind, können Agents außerdem bei der Vorbereitung und Durchführung von Auswirkungsanalysen helfen.
Sie können auch bei Policy-as-Code, Hersteller-Adaptern, Architekturdokumentation und Referenztests unterstützen. Das interne Team prüft diese Artefakte und entscheidet, welche Patterns für die Produktion freigegeben werden. AI unterstützt die Engineering-Arbeit, während das Unternehmen die Designhoheit und die Fähigkeit behält, die Entscheidungswege nachzuvollziehen.
Operations Agents nutzen diesen Kontext, um reale Störungen zu untersuchen. Im Beispiel der verzögerten Aktivierung könnte ein Agent eine Auftragskennung mit Anwendungs-Logs oder Traces, Nachrichtenstatus und Infrastrukturereignissen korrelieren, sofern die erforderliche Instrumentierung vorhanden ist.
Möglicherweise stellt er fest, dass ein Anwendungs-Workload in ein neues Subnetz verschoben wurde, während eine freigegebene Connectivity Policy noch auf den vorherigen Adressbereich verweist. Diese Hypothese muss anhand der bereitgestellten Regeln und des beobachteten Datenverkehrs geprüft werden. Andere Ursachen – etwa ein Anwendungsfehler, abgelaufene Zugangsdaten oder eine fehlgeschlagene Nachrichtenzustellung – bleiben möglich, bis die Belege die Ursache ausreichend eingrenzen.
Sobald die Ursache feststeht, kann ein Agent eine klar begrenzte Änderung vorbereiten, Genehmigungen einholen und innerhalb der erlaubten Autonomiestufe getestete Automatisierung aufrufen. Deterministische Kontrollen validieren die vorgeschlagene Aktion; die Ausführungsschicht setzt sie um. Prüfungen nach der Änderung verifizieren die betroffene Anwendungsinteraktion und – mit entsprechender Anwendungstelemetrie – das erwartete Aktivierungsergebnis. Sicherheitsprüfungen bestätigen, dass die Änderung innerhalb der beabsichtigten Grenzen geblieben ist.
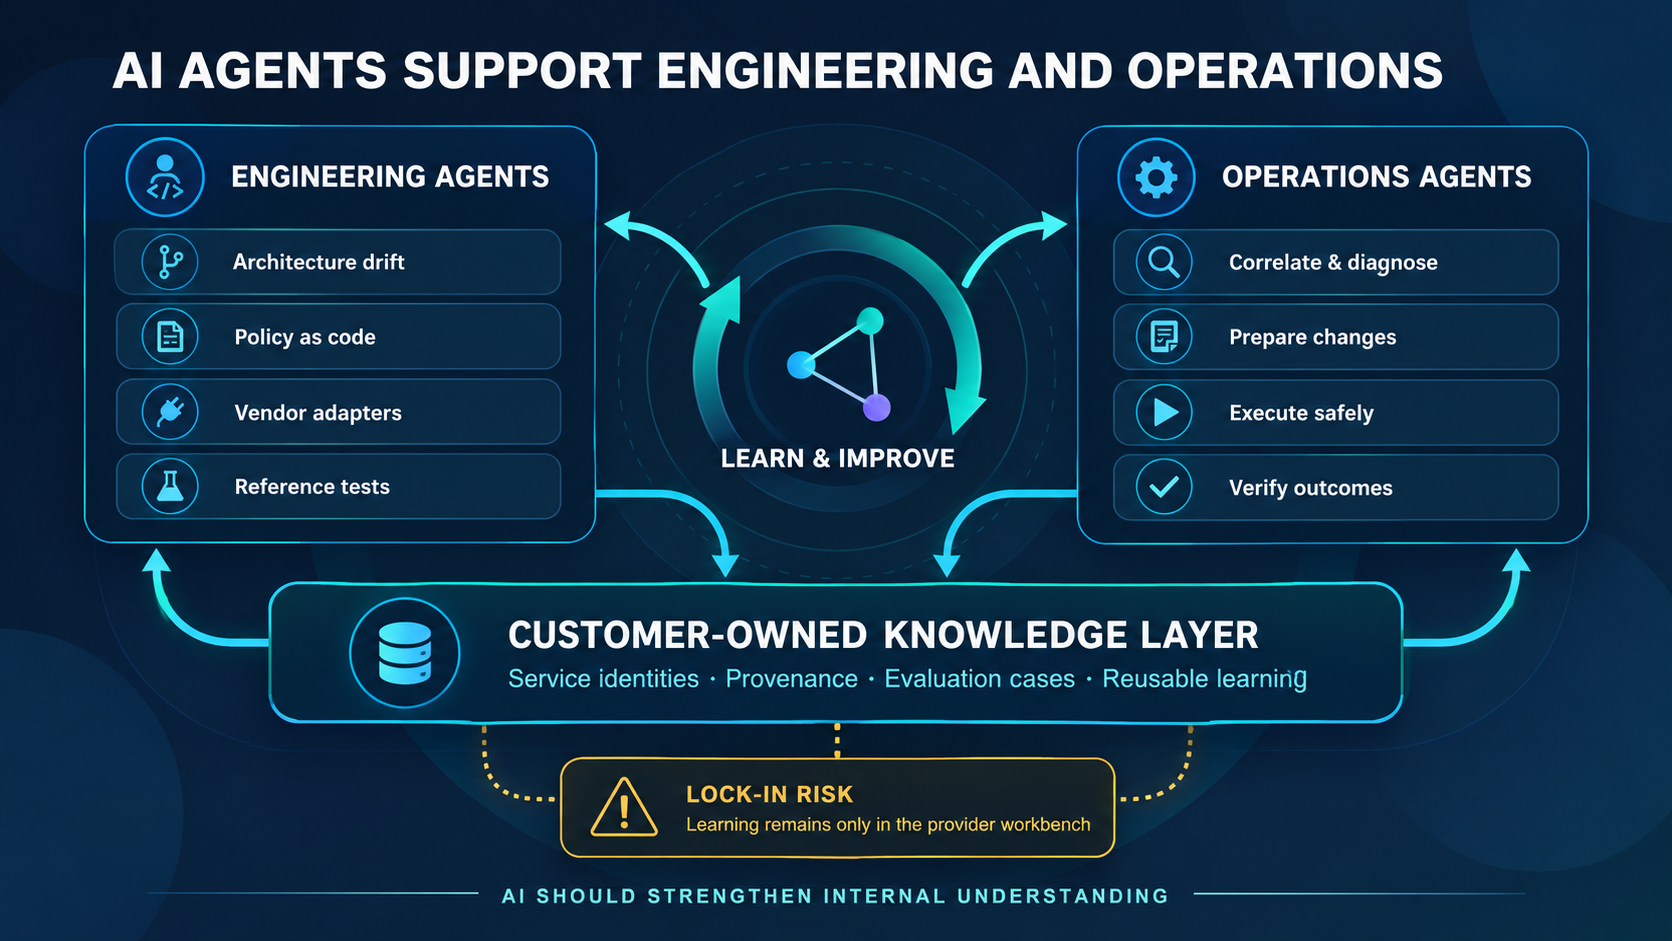
Jede Untersuchung kann außerdem wiederverwendbares Wissen erzeugen: eine korrigierte Abhängigkeit, eine verifizierte Diagnosesequenz, eine zuvor nicht dokumentierte Ausnahme oder einen zusätzlichen Regressionstest.
Lernen bedeutet hier, diese Artefakte bewusst zu aktualisieren und zu validieren. Es bedeutet nicht, dass sich ein Foundation Model automatisch neu trainiert, sobald ein Ticket geschlossen wird. Vorgeschlagene Erkenntnisse benötigen Herkunftsnachweise, eine angemessene Prüfung und eine Versionshistorie, bevor sie als vertrauenswürdiger Kontext für spätere Entscheidungen dienen.
Wenn dieser Prozess ausschließlich innerhalb der Workbench des Providers stattfindet, kann der Provider ein exklusives praktisches Verständnis des Services aufbauen. Seine Agents wissen möglicherweise, welche Inventareinträge unzuverlässig sind, welche Anwendungskennungen zu welchen Workloads gehören und welche Prüfreihenfolge einen Netzwerkfehler von einem Anwendungsproblem unterscheidet. Interne Architekturdokumente können diesem operativen Wissen zunehmend hinterherhinken.
Bei einem Ausstieg würden Konfigurationsdateien und Ticketexporte erhebliche Lücken hinterlassen, wenn das Unternehmen folgende Informationen nicht wiederverwenden könnte:
- die Beziehungen zwischen Service, Anwendungen und Infrastruktur,
- kundenspezifische Diagnoseabläufe und Agent-Anweisungen,
- freigegebene Zuordnungen, Ausnahmen und die dazugehörigen Nachweise,
- Evaluationsfälle und akzeptierte Ergebnisse,
- sowie die Prüfungen zur Validierung eines Service-Ergebnisses.
Der Wissenskreislauf sollte validierte Erkenntnisse deshalb in eine kundeneigene Wissensschicht zurückschreiben, die von Engineering und Betrieb gemeinsam genutzt wird. Bedeutende Agent-Aktionen sollten nachvollziehbar dokumentieren, welche Eingaben, Modell- und Werkzeugversionen, Policy-Prüfungen, Genehmigungen, Ausführungen und Ergebnisse beteiligt waren.
Der Provider kann seine allgemeinen Werkzeuge und sein Fachwissen behalten. Das Unternehmen benötigt die Rechte, den Zugriff und die praktisch getestete Fähigkeit, sein kundenspezifisches Service-Wissen weiterzuverwenden. So stärken operative Verbesserungen das interne Engineering, anstatt es schrittweise zu ersetzen.
8. Die Workbench kann zur eigentlichen Anbieterabhängigkeit werden
Die zentrale Abhängigkeit kann in der Workbench liegen, die Infrastruktur-Nachweise mit Anwendungsverhalten und Service-Ergebnissen verbindet.
Ein Provider kann hervorragende Dashboards anbieten und Rohdaten exportierbar machen, während die entscheidenden Beziehungen in proprietären Integrationen, Agent-Workflows oder undokumentierten Betriebskonventionen verborgen bleiben. Diese Beziehungen später zu rekonstruieren, kann zum schwierigsten Teil eines Providerwechsels werden.
Portabilität erfordert deshalb mehr als den Zugriff auf Dateien. Sie benötigt verständliche Schemata, stabile Kennungen, nachvollziehbare Zuordnungen und Referenzfälle, die in einer anderen Umgebung ausgeführt und bewertet werden können.
Zwei Firewall-Hersteller lösen diese Abhängigkeit nicht. Auch der Besitz der Quelldaten allein garantiert noch nicht, dass diese praktisch nutzbar bleiben. Der entscheidende Test ist, ob der Kunde das Service-Verständnis außerhalb der aktuellen Workbench rekonstruieren und validieren kann.
9. Der praktische Exit-Test
Wählen Sie in einer kontrollierten Umgebung ein repräsentatives Order-to-Activation-Szenario mit einem definierten Startpunkt, einem Abschlusszustand und klaren Abnahmekriterien aus.
Exportieren Sie die relevanten Service-Beziehungen, Anwendungsschnittstellen, Laufzeit-Zuordnungen, den Connectivity Intent, Policies, Diagnoseabläufe und Testfälle in nutzbaren Formaten. Reproduzieren Sie anschließend den Untersuchungs- und Assurance-Ablauf außerhalb der operativen Workbench.
Führen Sie einen bekannten Fehler in einer unterstützenden Abhängigkeit ein. Kann das interne Team oder ein Ersatzprovider die betroffene Anwendung und den Service identifizieren, die Nachweise erklären, eine autorisierte Wiederherstellung vorbereiten und das Ergebnis verifizieren? Gelingt dies ohne undokumentierte Hilfe des bisherigen Providers?
Testen Sie zusätzlich den Austausch eines Firewall-Adapters anhand eines definierten Satzes erforderlicher Sicherheits- und Connectivity-Eigenschaften. Unterschiede zwischen den Fähigkeiten der Hersteller sollten dokumentiert und bewertet werden, anstatt von einer automatischen Übertragbarkeit auszugehen.
Messen Sie fehlende Informationen, manuellen Rekonstruktionsaufwand und verbleibende proprietäre Abhängigkeiten. Der Test zeigt, was tatsächlich übertragbar ist und an welchen Stellen zusätzliche Engineering- oder vertragliche Regelungen erforderlich sind.
10. Das Betriebsmodell muss portabel bleiben
Ein Provider kann eine hybride Umgebung effizient über mehrere Technologien hinweg betreiben. AI Agents können Untersuchung, Engineering und Ausführung in dieser Umgebung verbessern.
Das Unternehmen muss das Wissen behalten, das seine Infrastruktur mit den Anwendungen und den von diesen Anwendungen gelieferten Service-Ergebnissen verbindet. Dafür braucht es interne Architektur- und Engineering-Kompetenz, eine klar verantwortliche Service-Ownership und einen erprobten Weg, das Wissen in einer anderen Umgebung weiterzuverwenden.
Der Betrieb kann ausgelagert werden. Die Fähigkeit der Organisation, ihre Services zu verstehen, zu steuern und weiterzuentwickeln, muss bei den dafür verantwortlichen Menschen verbleiben.
Quellen und weiterführende Informationen
- TM Forum – Open Digital Architecture
- TM Forum – Product Ordering Management API, TMF622
- TM Forum – Service Ordering Management API, TMF641
- ETSI GS ZSM 002 – ZSM Reference Architecture
- RFC 9315 – Intent-Based Networking
- NIST SP 800-207A – Zero Trust in Multi-Cloud Environments
- NIST AI 600-1 – Generative Artificial Intelligence Profile