Vom Netzwerk-Client zum DNS-Eintrag – oder: Warum ein Sync wissen muss, was ihm gehört
Wie UniFi-Clients sicher nach Technitium gelangen: mit Ownership, Journal, Regressionstests und einem bestätigten Live-Durchlauf.
KI-generiertes Titelmotiv im Stil der Homelab-Serie.
In UniFi steht das Gerät längst in der Clientliste: mit Namen und IP-Adresse. In meinem DNS fehlt der passende Eintrag noch. Also dieselben Informationen ein zweites Mal pflegen? Für wenige Geräte geht das. Sobald sich Adressen oder Namen ändern, wird daraus eine wiederkehrende Aufgabe. Genau dafür habe ich in meinem Homelab einen Abgleich zwischen UniFi und Technitium aufgebaut. Die Idee klingt überschaubar: Clientdaten lesen, DNS-Einträge anlegen, fertig. Interessant wird es bei der nächsten Frage: Was darf die Automatisierung verändern – und woran erkennt sie das nach einem Neustart noch? Den vollständigen Quellcode, die Dokumentation und die Tests findet ihr in meinem Repository unifi-technitium-dns-sync auf GitHub.
Zwei Systeme mit unterschiedlichen Aufgaben
UniFi liefert die Informationen über die Netzwerk-Clients, Technitium verwaltet die DNS-Zonen. Der Sync verbindet beide innerhalb eines festgelegten Bereichs. Dabei gehören zwei Einträge zusammen: Ein A-Record ordnet einem Namen eine IPv4-Adresse zu, ein PTR-Record ermöglicht die Rückwärtsauflösung von der Adresse zum Namen. Der Dienst behandelt beide als logisches Paar und übernimmt damit eine klar begrenzte Pflegeaufgabe. DHCP wird dadurch weder nach Technitium verschoben noch dort eingerichtet. Der veröffentlichte Stand unterstützt einen oder mehrere festgelegte IPv4-Netzbereiche. Sie dürfen sich nicht überschneiden; in einem gemeinsamen DNS-Namensraum müssen die gewünschten Gerätenamen eindeutig sein. Projektbeschreibung
Ein passender Eintrag gehört mir noch lange nicht
Angenommen, ein DNS-Eintrag existiert bereits und Name sowie Adresse passen zu einem Client aus UniFi. Darf der Sync ihn künftig ändern oder löschen? In meinem Konzept reicht diese Übereinstimmung nicht aus, denn der Eintrag könnte von Hand angelegt worden sein oder zu einem anderen Dienst gehören. Deshalb merkt sich der Sync in einer SQLite-Datenbank, welche Einträge er selbst vollständig angelegt und überprüft hat. Diese gespeicherte Zuständigkeit wird häufig als Ownership bezeichnet.
Vor einer späteren Löschung muss außerdem der tatsächliche DNS-Wert noch genau zu dem gespeicherten Wert passen. Wurde der Eintrag zwischenzeitlich verändert, ist das ein Anlass zur Prüfung. Die Automatisierung soll dann keine vermeintliche Ordnung herstellen und dabei eine bewusste Änderung beseitigen. Ein eigener Namensraum hilft zusätzlich: Dynamische Client-Einträge bekommen einen definierten Platz, und die Zugriffsrechte lassen sich auf die dafür vorgesehenen Zonen begrenzen.
Zwei Schreibvorgänge sind noch keine Transaktion
Der A-Record ist angelegt, doch bevor der PTR-Record folgt, startet der Container neu. Genau für solche Unterbrechungen braucht der Dienst ein Gedächtnis. Vor dem ersten DNS-Schreibzugriff speichert er seine Absicht dauerhaft, schreibt den A-Record und liest ihn zur Kontrolle wieder aus. Anschließend folgen der PTR-Record und dessen Kontrolle. Erst wenn das Paar bestätigt ist, wird der Vorgang als abgeschlossen gespeichert. Die dokumentierten Zustände heißen RESERVED, A_CREATED und COMPLETE. Beim nächsten Lauf prüft der Dienst zunächst offene Vorgänge gegen den tatsächlichen DNS-Zustand. Ein erklärbarer Zwischenstand kann weitergeführt werden; ein unerklärlicher Zustand wird als Konflikt festgehalten und blockiert weitere Schreibaktionen. Dokumentiertes Sicherheitsmodell
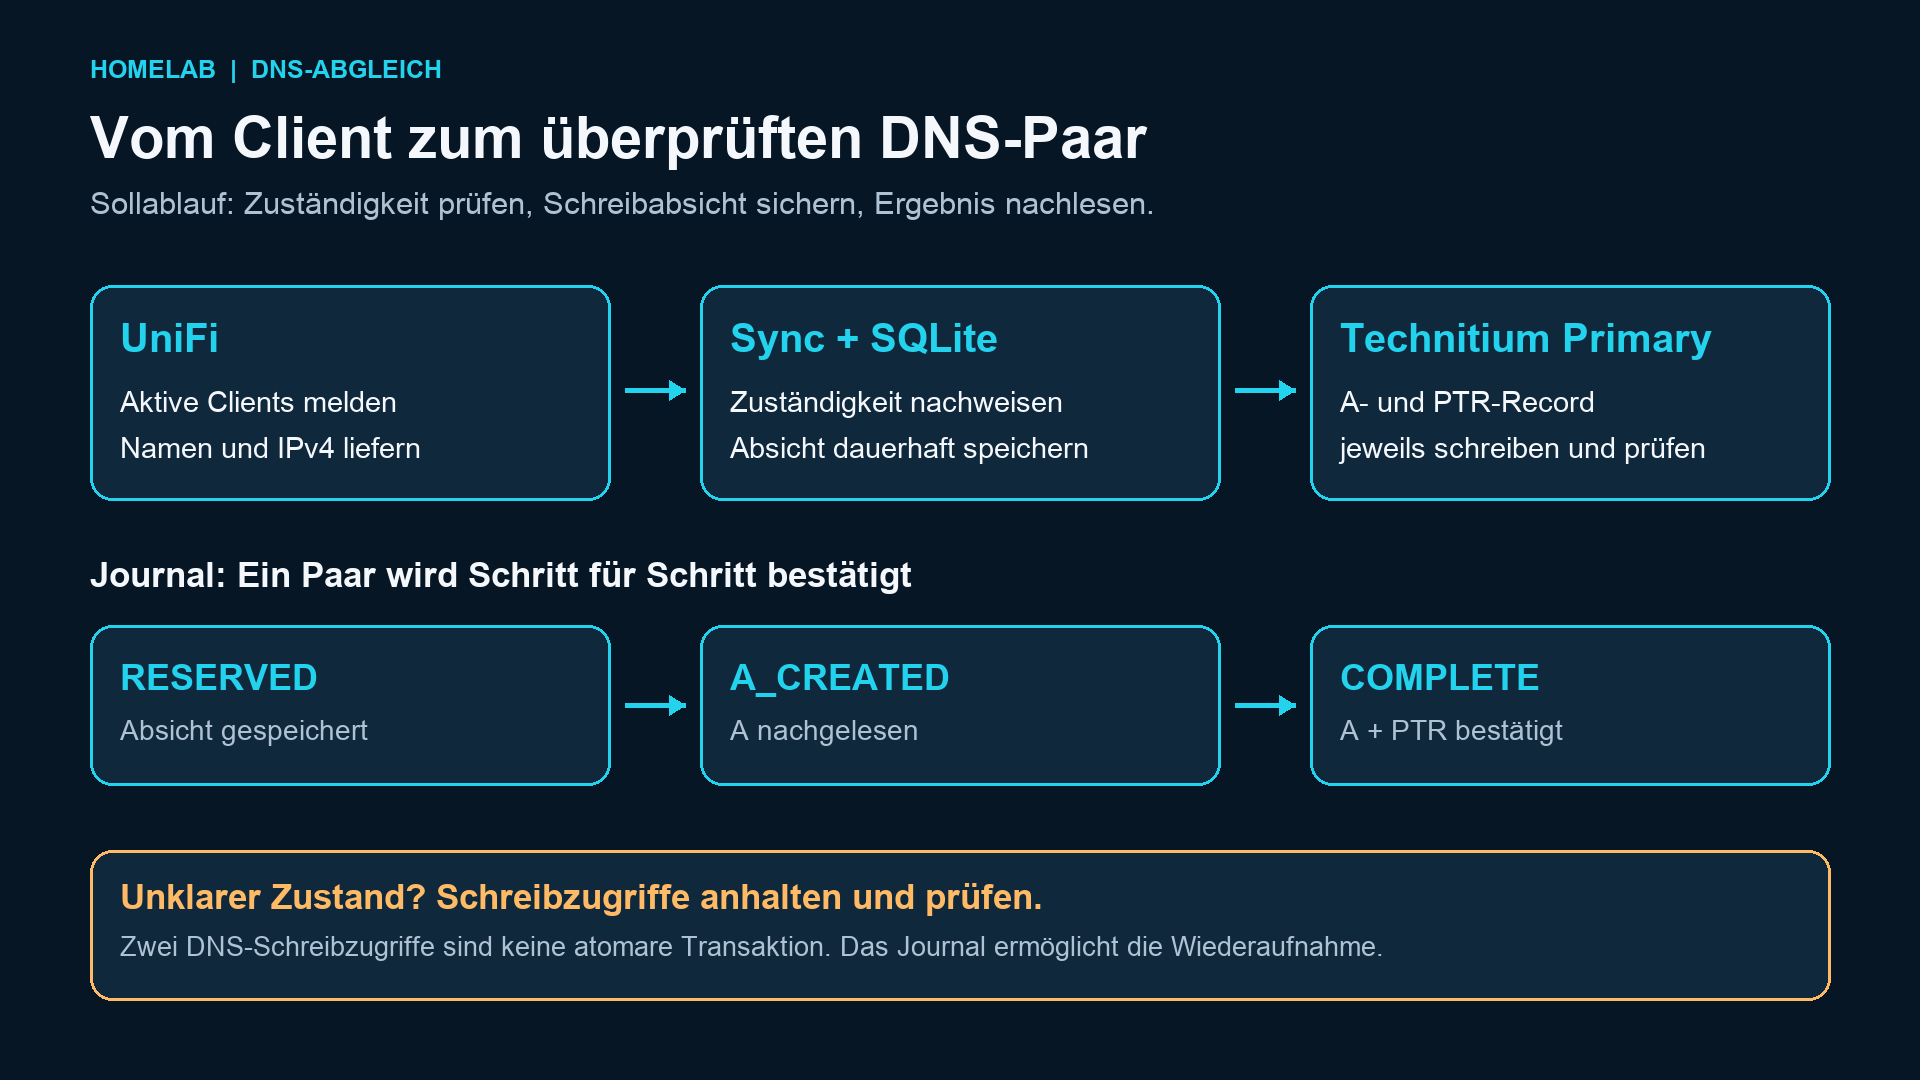
Sollablauf: Erst die Absicht sichern, dann beide DNS-Einträge schreiben und nachlesen. Eigene Darstellung.
Das macht die beiden DNS-Schreibzugriffe nicht atomar; Zwischenstände bleiben möglich. Das Journal soll sie nachvollziehbar machen und einen kontrollierten Wiederanlauf ermöglichen. Für mich ist das eine der wichtigsten Entscheidungen des Projekts: Ein Neustart darf nicht dazu führen, dass der Dienst seine eigene halbfertige Arbeit nicht mehr erkennt.
Der erreichbare Server ist nicht automatisch der richtige
Bei mehreren DNS-Servern liegt eine Versuchung nahe: Antwortet einer nicht, probiert man den anderen. Für Schreibzugriffe braucht es eine genauere Entscheidung. Der Sync ermittelt deshalb, welcher Technitium-Knoten aktuell die Primary-Rolle hat. Ein erreichbarer Secondary wird nicht ersatzweise zum Schreibziel. Ist der zuständige Primary nicht erreichbar, bleibt der Abgleich ohne DNS-Änderung stehen. Für diese Verwaltungsaufgabe akzeptiere ich lieber eine verzögerte Aktualisierung, als die Zuständigkeit des Clusters zu übergehen. Primary-Erkennung im Projekt
Verschwunden heißt nicht sofort löschen
Ein ausgeschaltetes Notebook ist kein ausgemustertes Notebook. Deshalb darf ein Client, der gerade nicht in der aktiven Liste auftaucht, nicht sofort seinen DNS-Eintrag verlieren. Im dokumentierten Aufbau gilt eine Schonfrist von 30 Tagen. Maßgeblich ist, wann der Client zuletzt gesehen wurde. Zusätzlich muss der Eintrag dem Sync gehören und noch exakt dem gespeicherten Wert entsprechen; auch die Löschabsicht wird vorab dauerhaft festgehalten. Bei einer geänderten IP-Adresse oder einem neuen Namen gilt eine andere Reihenfolge: Zuerst wird das neue Paar aufgebaut und überprüft, erst danach werden die bisherigen eigenen Werte gezielt entfernt. So wird die Bereinigung zu einem überprüfbaren Schritt im Ablauf.
Erst beobachten, dann schreiben lassen
Der Einstieg erfolgt mit einem Dry-Run. Der Dienst liest die beteiligten Systeme und zeigt seine geplanten Aktionen, ohne DNS zu verändern. Das ist die Gelegenheit, Namenskonflikte und einen falsch gewählten Zuständigkeitsbereich zu erkennen. Vor dem ersten schreibenden Lauf gehören für mich drei Dinge zusammen: ein geprüfter Plan, eine Sicherung aller verwalteten Forward- und Reverse-Zonen samt Sync-Zustand und Zugangsdaten mit begrenzten Rechten. Diese Vorgehensweise ist auch in der Security Policy des Projekts festgehalten.
Hier schließt sich der Kreis zum Infisical-Beitrag der Serie. In meinem dokumentierten Aufbau lädt ein vorgeschalteter Prozess die benötigten API-Secrets aus Infisical und übergibt sie an den Sync. Die Identität, mit der dieser Abruf erfolgt, bleibt selbst Teil der geschützten Betriebskonfiguration. Auch die SQLite-Datei gehört ins Backup: Sie enthält die Zuständigkeiten und offenen Vorgänge, auf die sich spätere Entscheidungen stützen. DNS-Zonen und Sync-Zustand müssen deshalb gemeinsam in der Wiederherstellungsplanung vorkommen.
Was die Tests belegten – und was im Betrieb fehlte
Der vollständige Projektstand liegt auf GitHub. Die ersten 13 automatisierten Tests waren erfolgreich. Trotzdem zeigte sich im Betrieb ein Fehler, den diese Tests nicht erfassten:
cannot start a transaction within a transaction
Ein erster kurzer Logausschnitt machte das Problem sichtbar. Ein späterer Export über rund 22 Stunden bestätigte 266 Abbrüche mit derselben Meldung und keinen vollständigen Sync-Abschluss. Die APIs waren erreichbar; der Fehler entstand beim Umgang mit dem lokalen Zustand. Wenn ein vorhandenes DNS-Paar unverändert passte, aktualisierte der Sync dessen letzten Prüfzeitpunkt in SQLite. Auch dieser kleine Schreibvorgang öffnete eine Datenbanktransaktion. Beim nächsten Client sollte ein neues Paar entstehen, wofür der Dienst eine eigene Journal-Transaktion beginnen wollte – die vorherige war jedoch noch offen. Das erklärt, weshalb ein erfolgreicher Test „neues Paar anlegen“ allein nicht genügt. Entscheidend ist auch die Reihenfolge im vollständigen Durchlauf: erst ein bestehender Client ohne DNS-Änderung, danach ein neuer Client mit Schreibbedarf.
Die Korrektur und die fehlenden Tests
Die Korrektur fasst die beiden Prüfzeitpunkte für A und PTR in einer gemeinsamen SQLite-Transaktion zusammen und schließt sie unmittelbar ab. Scheitert eines der Updates, werden beide zurückgerollt. Die Journal-Absicht wird weiterhin dauerhaft gespeichert, bevor DNS verändert wird. Fehlerbehebung
Drei zusätzliche Tests prüfen nun die bisher fehlenden Abläufe: ein unverändertes Paar vor einer Neuanlage, einschließlich eines weiteren Netzes und eines wiederholten Durchlaufs; ein unverändertes Paar vor einer Änderung samt Bereinigung; und ein Fehler beim Speichern der Prüfzeitpunkte mit anschließendem erfolgreichen Wiederholungsversuch. Vor der Korrektur schlugen diese Tests fehl. Für den korrigierten Stand sind alle 16 Tests unter Python 3.11, 3.12 und 3.13 erfolgreich. Syntaxprüfung, Paketinstallation und beide Docker-Builds sind ebenfalls erfolgreich. Testlauf · Docker-Build
Der erste bestätigte Live-Abschluss nach der Korrektur
Nach dem Einspielen der Korrektur und dem Neustart meldet der Dienst am 19. Oktober 2026 um 20:49:58 Uhr MESZ erstmals in den danach bereitgestellten Logs SYNC_COMPLETE für alle drei konfigurierten Netze. Schreibzugriffe waren aktiviert. Die Abschlussmeldung zählt 82 verbundene Clients, davon 64 innerhalb der konfigurierten Bereiche und 51 DNS-Kandidaten. Diese 51 stehen für den Umfang des Abgleichs, nicht für 51 neu angelegte Einträge. Im sichtbaren Ausschnitt sind DNS-Schreibzugriffe, abgeschlossene Paarvorgänge und Bereinigungen tatsächlich protokolliert; der SQLite-Transaktionsfehler tritt dort nicht mehr auf.
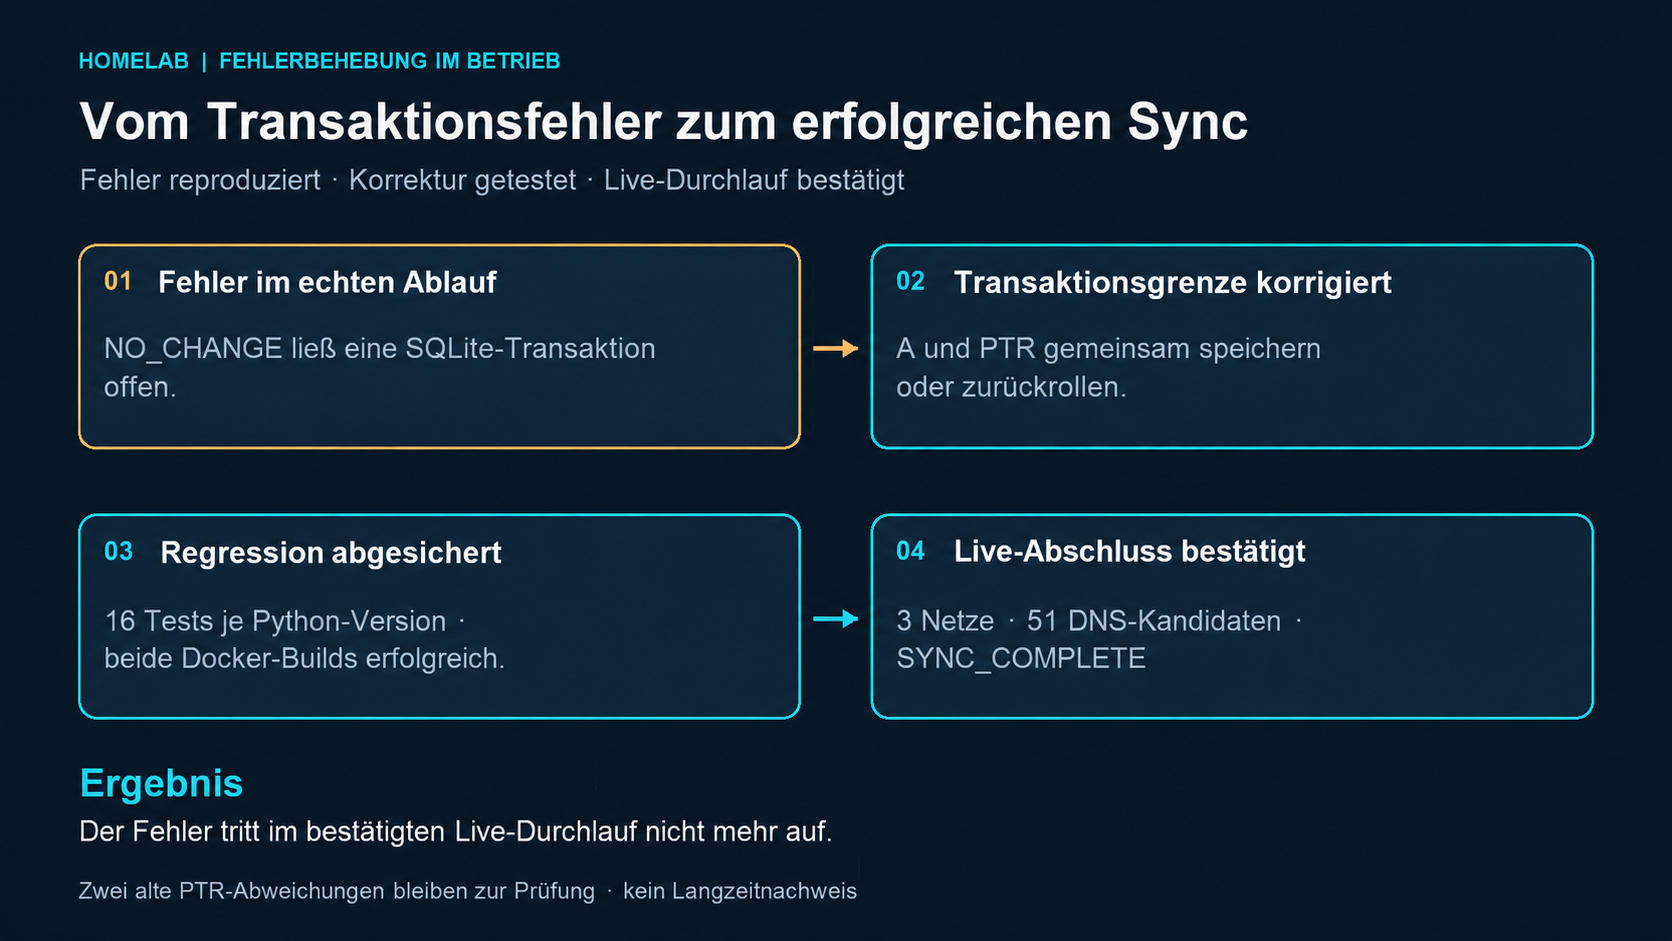
Fehlerfolge, Korrektur, Regression und bestätigter Live-Abschluss auf einen Blick. Eigene Darstellung.
Zwei alte PTR-Einträge werden weiterhin mit ownership_drift übersprungen: Die gespeicherte Zuständigkeit verweist auf Einträge, die im DNS bereits fehlen. Der Sync verändert diese unklaren Fälle nicht und erreicht trotzdem den Abschluss. Die Ursache dieser Abweichungen bleibt zu prüfen. Der Nachweis hat außerdem eine klare Grenze: Der neue Export umfasst die letzten 100 Zeilen und zeigt das Ende eines erfolgreichen Laufs. Er belegt weder einen wochenlang stabilen Betrieb noch einen kontrollierten Absturz- oder Wiederherstellungstest.
Was als Nächstes bleibt
Die Überwachung soll erkennen, wann zuletzt ein vollständiger Sync erfolgreich war. Ein laufender Container und erreichbare APIs sagen darüber zu wenig aus. Außerdem bleiben eindeutige Gerätenamen, die beiden PTR-Abweichungen und eine längere, lückenlose Loghistorie auf der Liste. Echte Absturz-, Failover- und Restore-Tests stehen weiterhin aus. Die aktuelle Reverse-Zonen-Ableitung setzt ein /24-Schema voraus; IPv6 ist noch nicht unterstützt. Architektur und Grenzen
Mein Learning: Eine Automatisierung muss ihre Zuständigkeit kennen. Und ihre Tests müssen auch die Reihenfolge abbilden, in der echte Betriebsdaten auf sie treffen.
Wie verbindet ihr Netzwerkverwaltung und DNS – und woran erkennt eure Automatisierung, welche Einträge sie verändern darf?
#Homelab #UniFi #Technitium #DNS #Automatisierung #Infisical