DNS-Monitoring im Homelab: Was ein grünes Dashboard wirklich beweist
Wie ich zwei DNS-Server mit Prometheus, Grafana, Blackbox Exporter, Alertmanager und ntfy überwache – einschließlich kontrolliertem Ausfalltest und getesteter Alarmkette.
Im ersten Teil meiner Homelab-Serie habe ich zwei Raspberry Pis als redundante DNS-Server aufgebaut. Im zweiten Teil kamen Caddy, ein Reverse Proxy und öffentlich vertrauenswürdige TLS-Zertifikate für die internen Dienste hinzu.
Damit funktioniert die Infrastruktur. Aber woher weiß ich, dass sie morgen früh immer noch funktioniert – bevor jemand aus der Familie meldet, dass „das Internet kaputt“ ist?
Der nächste Schritt war deshalb ein eigenes Monitoring für dns01 und dns02. Mein Ziel war nicht einfach ein hübsches Dashboard. Ich wollte vier unterschiedliche Fragen beantworten:
Läuft der Raspberry Pi?
Ist er über das Netzwerk erreichbar?
Beantwortet der DNS-Dienst wirklich Anfragen?
Kommt ein Alarm tatsächlich bei mir an?
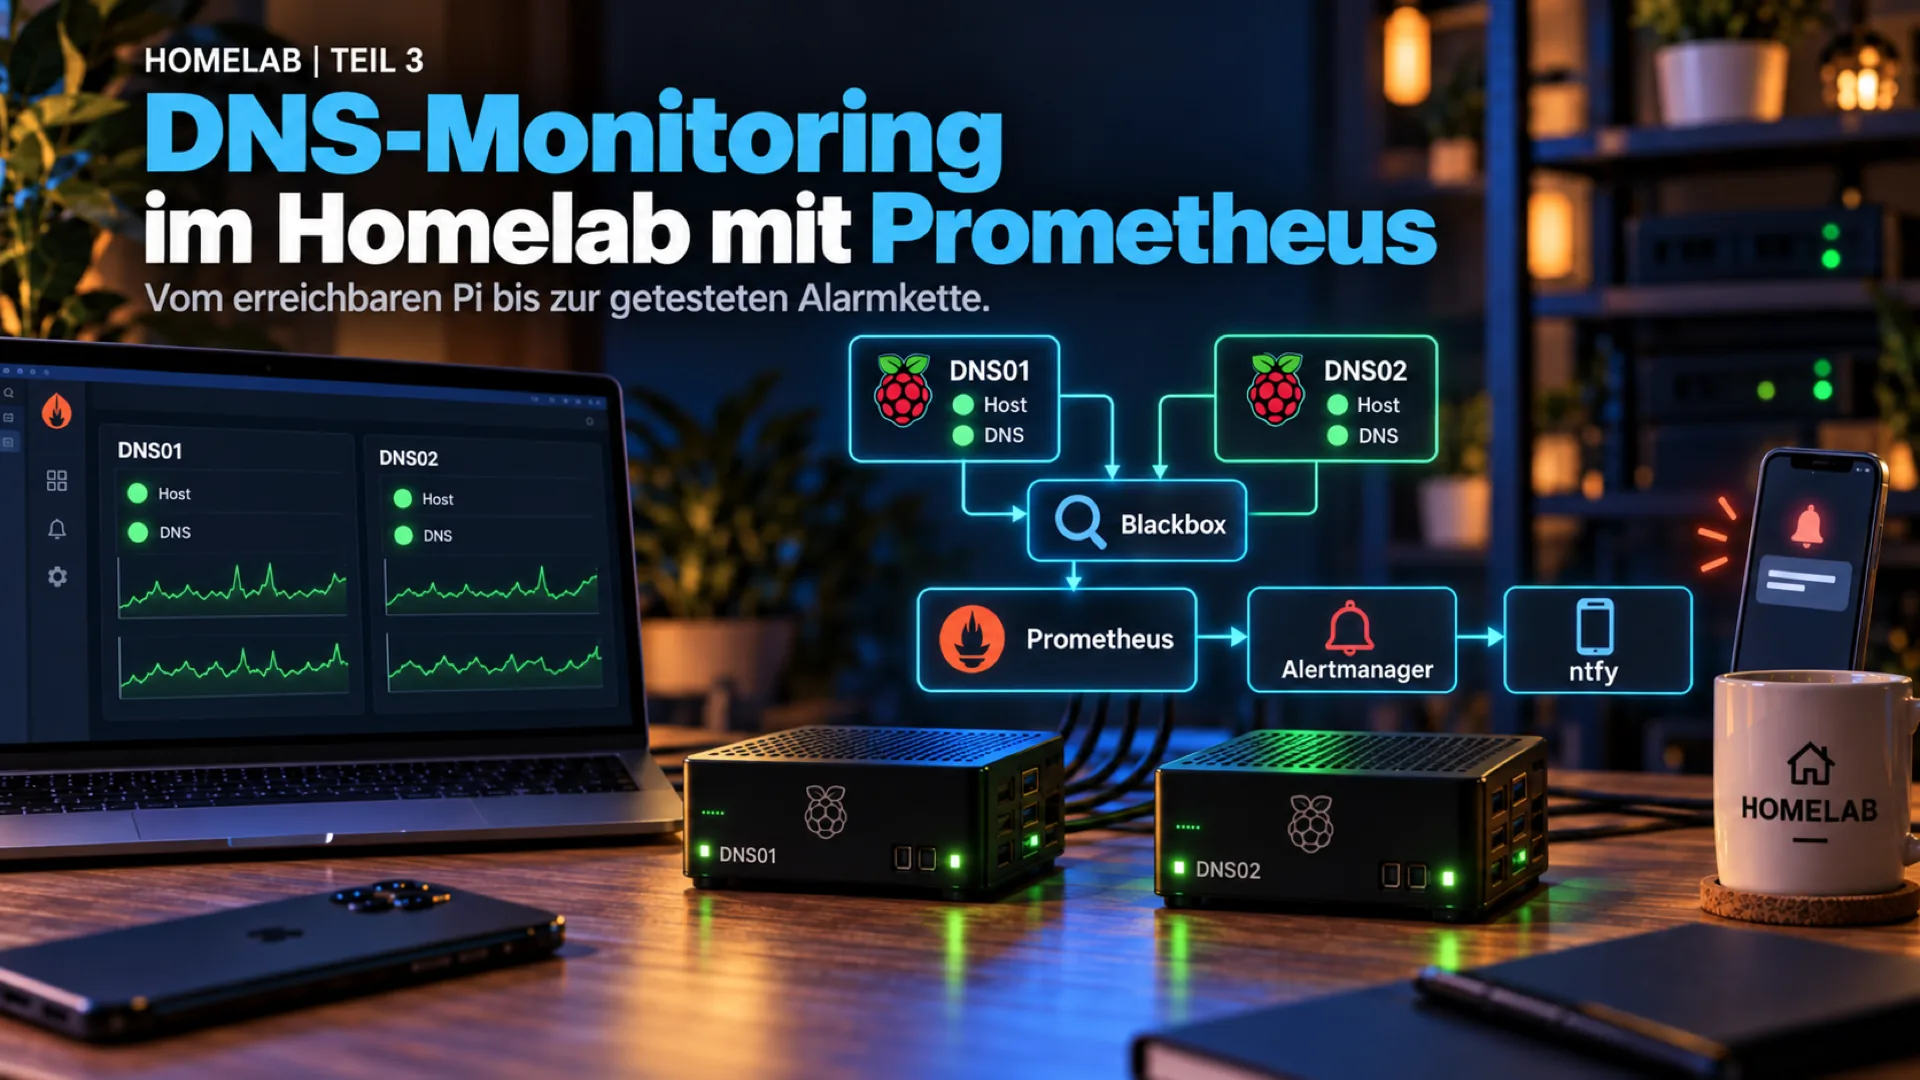
Die Prüfkette
Der Aufbau besteht aus mehreren Schichten:
DNS01 ── Node Exporter ──┐
                        ├── Prometheus ── Alertmanager ── ntfy
DNS02 ── Node Exporter ──┘        │
                                 └── Grafana

Blackbox Exporter
   ├── ICMP-Probe ──> DNS01 / DNS02
   └── DNS-Probe  ──> DNS01 / DNS02
Prometheus sammelt Messwerte und wertet Alarmregeln aus. Grafana macht die Daten sichtbar. Alertmanager gruppiert und verteilt Alarme. ntfy bringt die Meldung schließlich auf meine Geräte.
Diese Trennung ist wichtig: Ein Dashboard visualisiert nur, was die darunterliegenden Prüfungen tatsächlich messen. Wenn die Messung die falsche Frage stellt, macht auch eine perfekte Darstellung das Ergebnis nicht belastbarer.
Host-Zustand ist noch kein DNS-Zustand
Auf beiden Raspberry Pis läuft ein Node Exporter. Er liefert Betriebssystem- und Hardwaremetriken wie CPU-Auslastung, Arbeitsspeicher, freien Speicherplatz, Temperatur und Uptime. Damit sehe ich zum Beispiel, ob eine SD-Karte langsam vollläuft oder ein Pi ungewöhnlich heiß wird.
Das beweist aber noch nicht, dass DNS funktioniert.
Deshalb prüft ein Blackbox Exporter beide Systeme zusätzlich von außen. Eine ICMP-Prüfung beantwortet die Frage, ob der Host über das Netzwerk erreichbar ist. Eine DNS-Prüfung stellt tatsächlich eine Anfrage an den Resolver und misst, ob eine gültige Antwort zurückkommt – und wie lange das dauert.
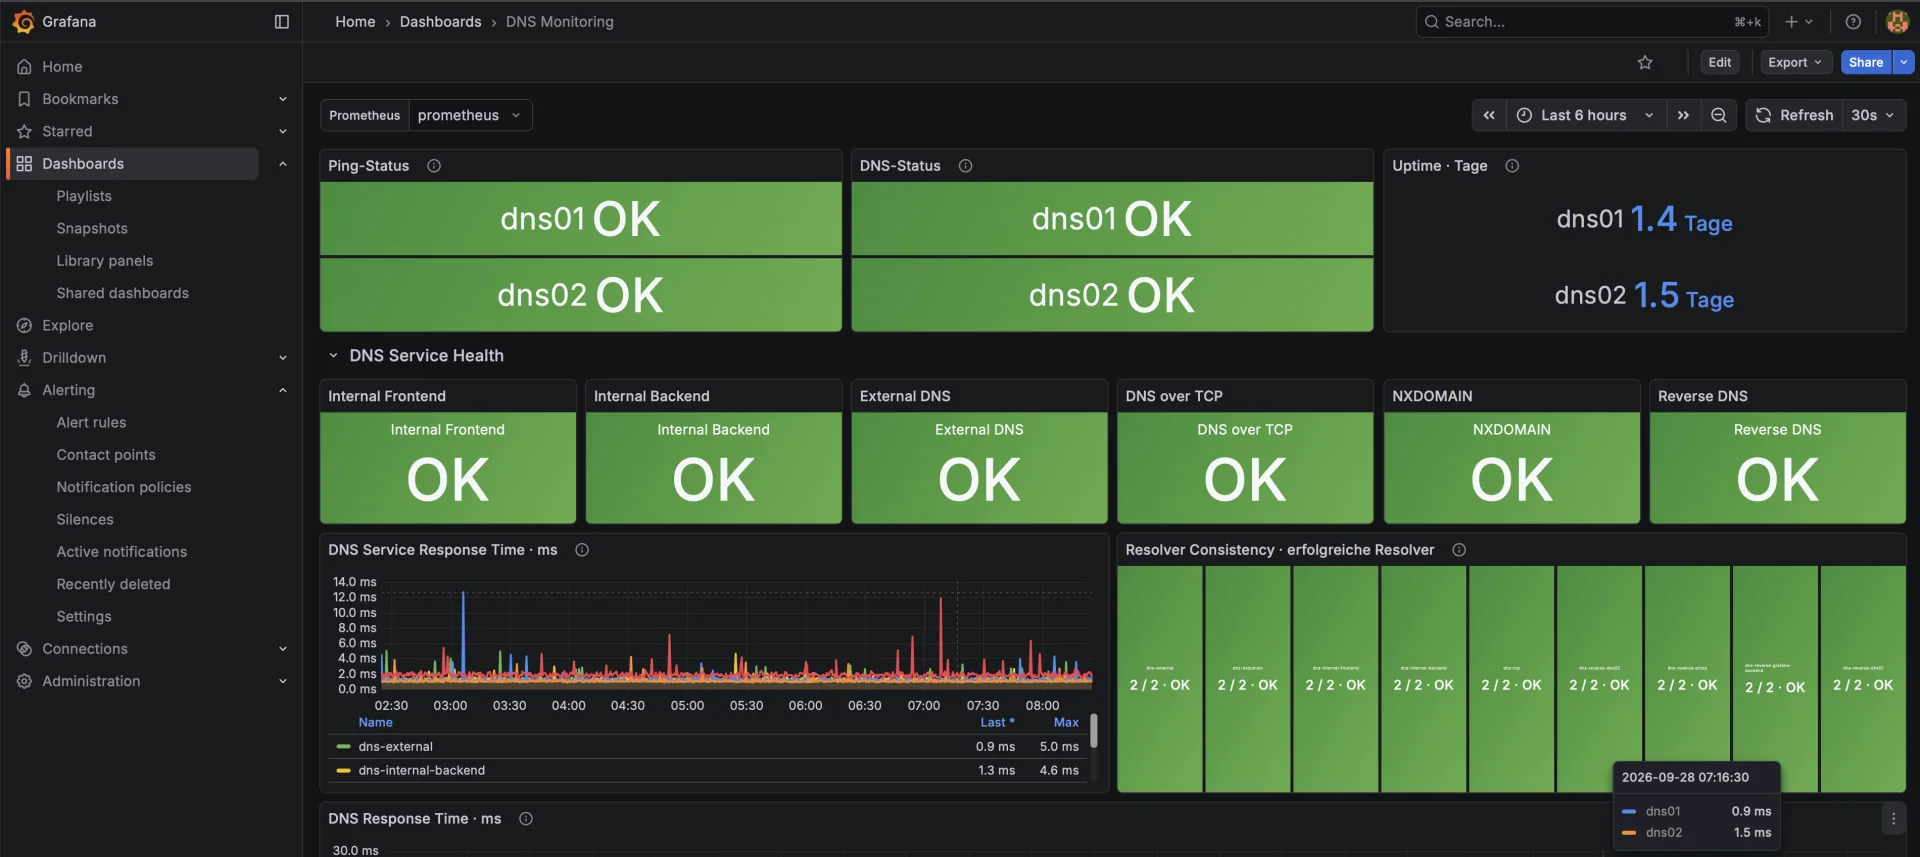
Im Normalzustand sind Host-Erreichbarkeit, DNS-Status und die einzelnen Resolver-Prüfungen getrennt sichtbar. Antwortzeiten bleiben dadurch genauso beobachtbar wie ein vollständiger Ausfall.
up und probe_success messen nicht dasselbe
Hier lag eines der wichtigsten Learnings:
Ein grünes
upbedeutet bei einem Blackbox-Job nicht automatisch, dass der geprüfte Dienst funktioniert.
up kann lediglich bedeuten, dass Prometheus den Blackbox Exporter erfolgreich abfragen konnte. Ob die eigentliche DNS-Prüfung erfolgreich war, zeigt erst probe_success.
up = 1             → Prometheus erreicht den Exporter
probe_success = 1  → Der DNS-Test war erfolgreich
Wer nur den ersten Wert beobachtet, kann ein wunderbar grünes Monitoring für einen ausgefallenen Dienst bauen. Für die Service-Aussage muss deshalb probe_success im Mittelpunkt stehen; up überwacht den Messweg zum Exporter.
DNS von außen und von innen beobachten
Die aktive Probe wird durch die Betriebsdaten in Technitium ergänzt. Dort sehe ich unter anderem erfolgreiche Antworten, NXDOMAIN, rekursive und autoritative Anfragen, Cache-Nutzung, Clients und Serverfehler. Das ersetzt die externe Probe nicht, hilft aber bei der Diagnose: Ist der Resolver komplett ausgefallen, liefert er nur bestimmte Antworten nicht oder verändert sich das Anfrageverhalten?
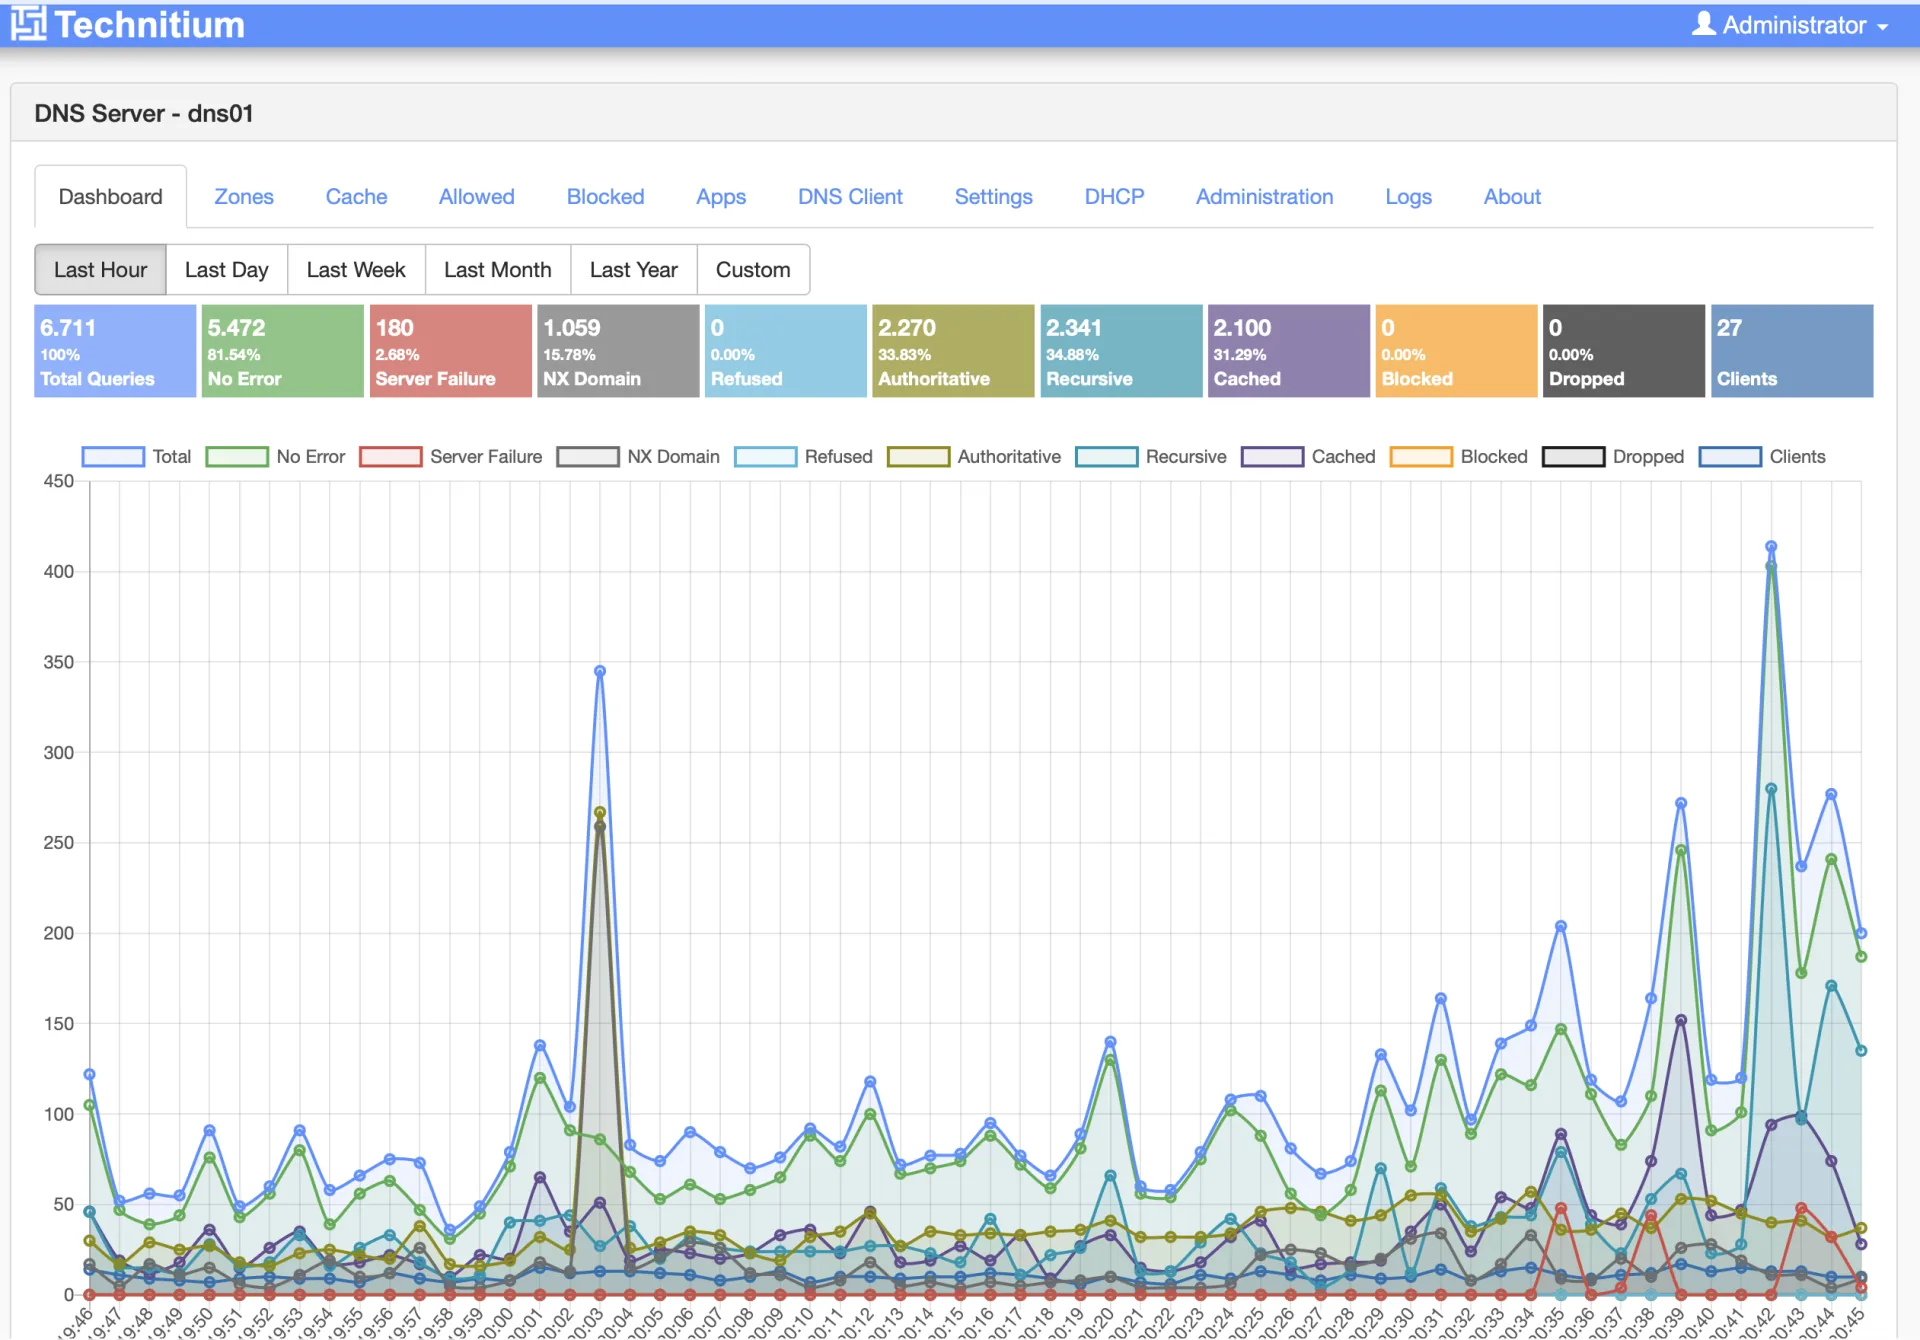
Technitium zeigt, was der Resolver verarbeitet. Der Blackbox Exporter prüft dagegen aus Sicht eines externen Clients, ob der gewünschte DNS-Pfad wirklich funktioniert.
Alarme mit Absicht verzögern
Für dns01 und dns02 sind unter anderem folgende Alarme eingerichtet:
| Prüfung | Reaktion |
|---|---|
| Host nicht erreichbar | Alarm nach 2 Minuten |
| DNS-Anfrage schlägt fehl | Alarm nach 2 Minuten |
| DNS-Antwort über 50 ms | Warnung |
| DNS-Antwort über 100 ms | Kritisch |
| CPU, RAM, Disk und Temperatur | abgestufte Warnungen |
Die Zeitverzögerungen sind bewusst gewählt. Nicht jeder einzelne verlorene Ping soll sofort eine Push-Nachricht auslösen. Ein Alarm sollte auf ein Problem hinweisen, auf das ich tatsächlich reagieren kann – nicht auf jedes kurze Rauschen im Netzwerk.
Bei der ersten vollständigen Prüfung waren 13 Prometheus-Targets aktiv. Zwölf geladene DNS-Alarmregeln waren technisch fehlerfrei und nicht ausgelöst. Das war ein guter Anfang, aber noch kein Beweis dafür, dass die Alarmkette funktioniert.
Der kontrollierte Ausfalltest
Der aussagekräftigste Test ist ein echter, kontrollierter Fehler. Während dns01 weiterarbeitete, wurde dns02 gezielt gestoppt. Das Dashboard wechselte den Ping- und DNS-Status des betroffenen Systems auf kritisch. Die davon abhängigen Service-Prüfungen gingen zunächst auf degradiert; Reverse DNS wurde als kritisch markiert. Gleichzeitig stiegen die gemessenen Antwortzeiten bis an das Probe-Timeout.
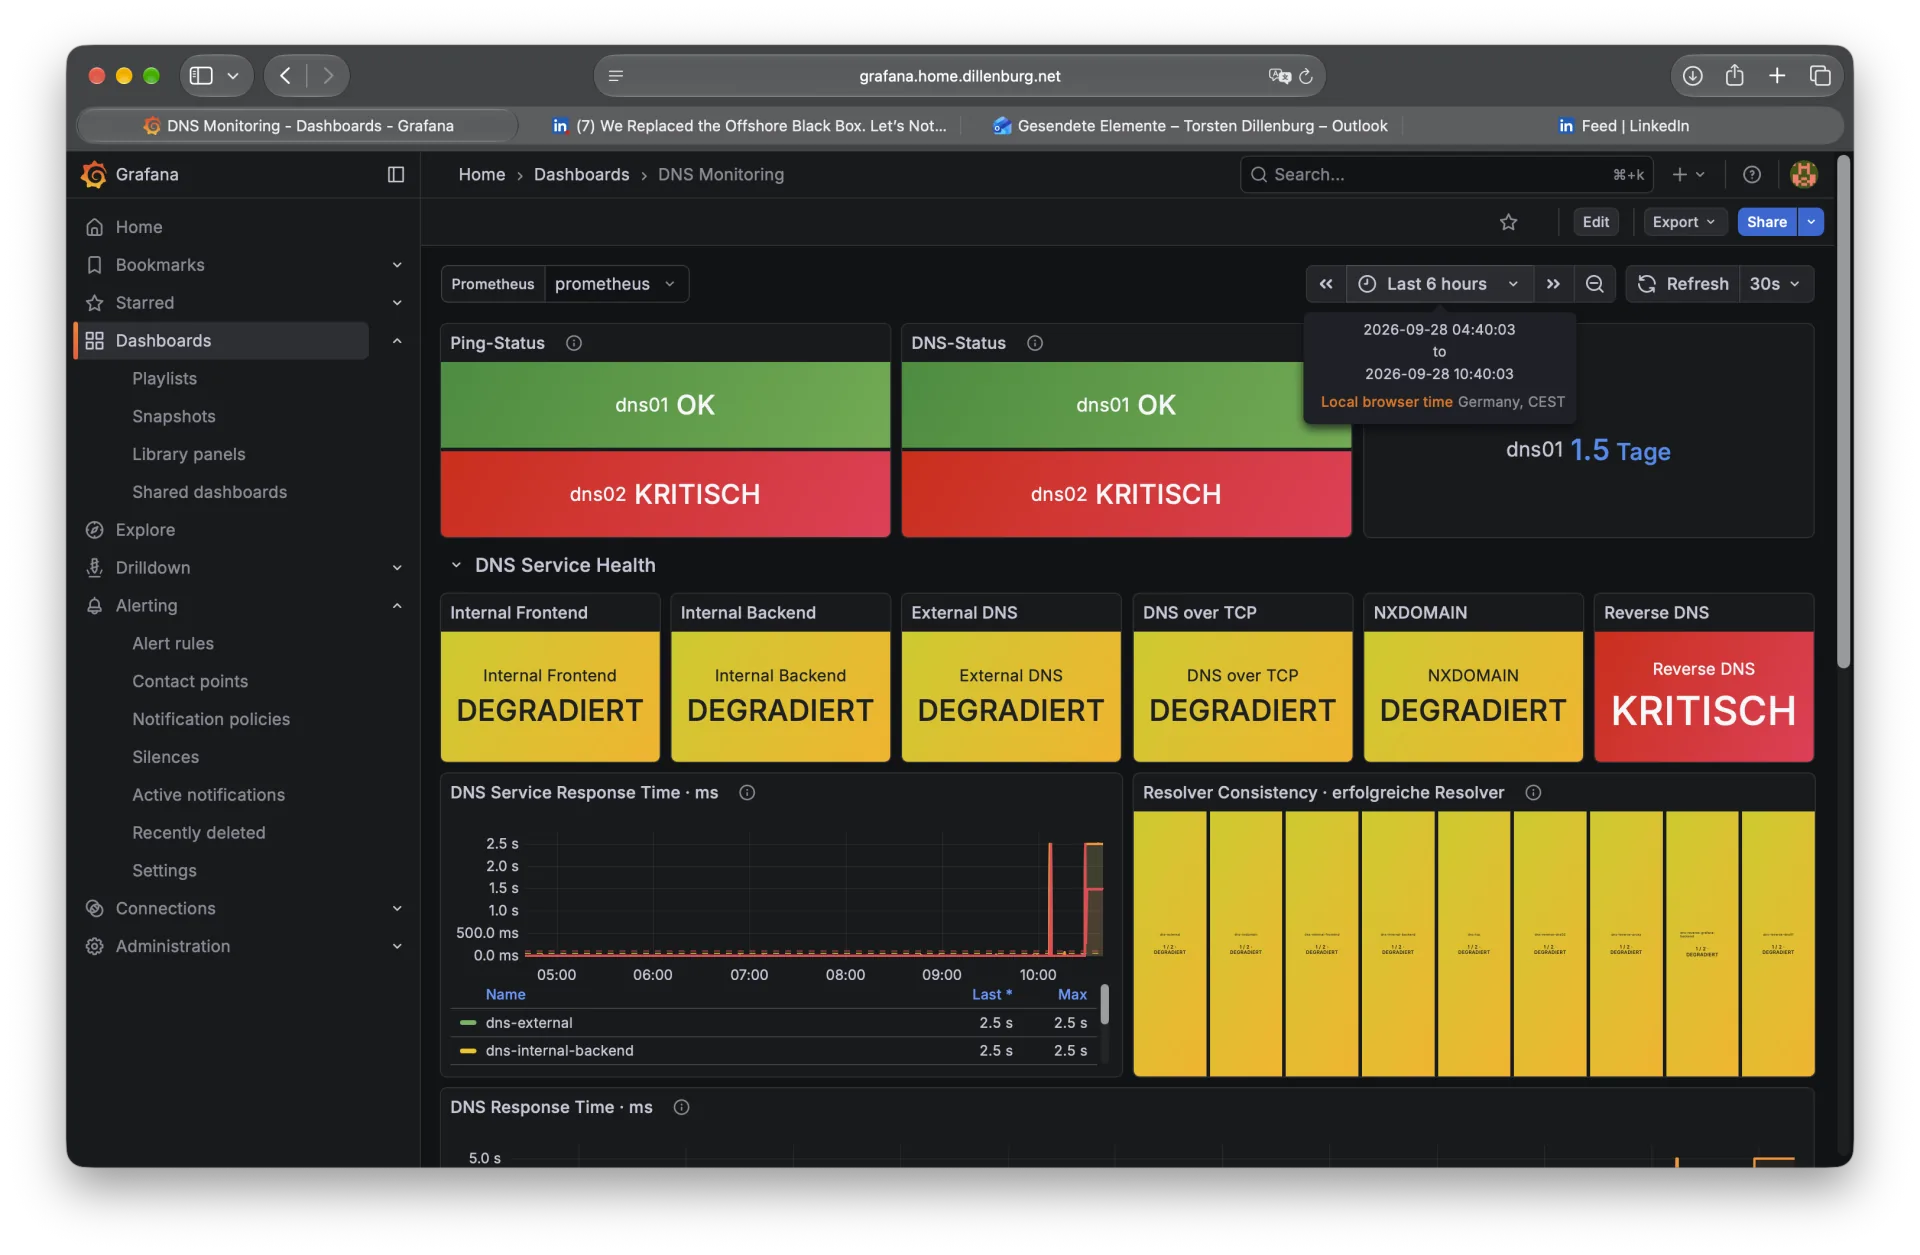
Der Fehler bleibt nicht als einzelner roter Kasten isoliert: Das Dashboard zeigt auch, welche DNS-Funktionen und Messwerte von diesem Ausfall betroffen sind.
Der Wiederanlauf ist genauso wichtig wie der Ausfall. Erst wenn Status, Antwortzeiten und abhängige Prüfungen wieder sauber auflösen, ist der Test vollständig.
Die Alarmkette bis zum Endgerät testen
Zusätzlich zum technischen Ausfalltest habe ich eine temporäre Testregel verwendet:
temporäre Testregel
       ↓
Prometheus erkennt den Alarm
       ↓
Alertmanager gruppiert und sendet
       ↓
Caddy stellt ntfy per HTTPS bereit
       ↓
Alarmmeldung kommt an          ✅
Entwarnung kommt ebenfalls an  ✅
Erst danach wurde die Testregel wieder entfernt. Gerade die Entwarnung war mir wichtig. Ein Monitoring, das nur Probleme meldet, aber nie sauber auflöst, verliert sehr schnell Vertrauen.
Grafana ist dabei hilfreich – aber nicht der Mittelpunkt des Systems:
Das Dashboard ist das Fenster. Die Alarmregeln und die getestete Zustellung sind das eigentliche Monitoring.
Was die aktuelle Probe noch nicht beweist
Die derzeitige DNS-Probe testet eine öffentliche A-Record-Abfrage über UDP und IPv4. Sie beweist noch nicht, dass meine interne Zone korrekt ist, Reverse DNS funktioniert, DNS über TCP antwortet oder die Zonenstände von Primary und Secondary übereinstimmen.
Die nächsten sinnvollen Erweiterungen sind deshalb:
- interne A- und PTR-Antworten prüfen,
- DNS über TCP testen,
- SOA-Seriennummern vergleichen,
- Alter und Erfolg der Backups überwachen.
Die Failure Domain des Monitorings
Prometheus, Alertmanager, ntfy und die Exporter laufen gemeinsam auf meinem QNAP. Fällt das NAS vollständig aus, kann sich diese Monitoring-Kette nicht selbst melden. Die beiden DNS-Pis könnten weiterhin funktionieren – ich wäre in diesem Moment aber blind. Oder sie fallen ebenfalls aus, ohne dass der interne Alarmweg noch existiert.
Ein unabhängiger externer Watchdog oder ein zweiter Meldeweg bleibt deshalb auf der Liste.
Fazit
Monitoring bedeutet nicht, möglichst viele grüne Werte zu sammeln. Monitoring bedeutet, genau zu wissen, was ein Wert beweist – und was nicht.
Auch im Homelab gelten die gleichen Prinzipien wie in größeren Infrastrukturen: technische Verfügbarkeit in Schichten prüfen, Symptome statt Einzelrauschen alarmieren, die komplette Meldekette testen und die Failure Domain des Monitorings selbst nicht vergessen.
Als Nächstes geht es um Backups und Wiederherstellung. Denn ein Alarm zeigt mir zwar, dass etwas kaputt ist – er stellt aber noch keinen DNS-Server wieder her.