DNS-Backup-Automatisierung im Homelab
Wie Technitium-Backups per API automatisiert, als ZIP validiert, defensiv aufbewahrt und mit Prometheus bis zur Alarmzustellung überwacht werden.
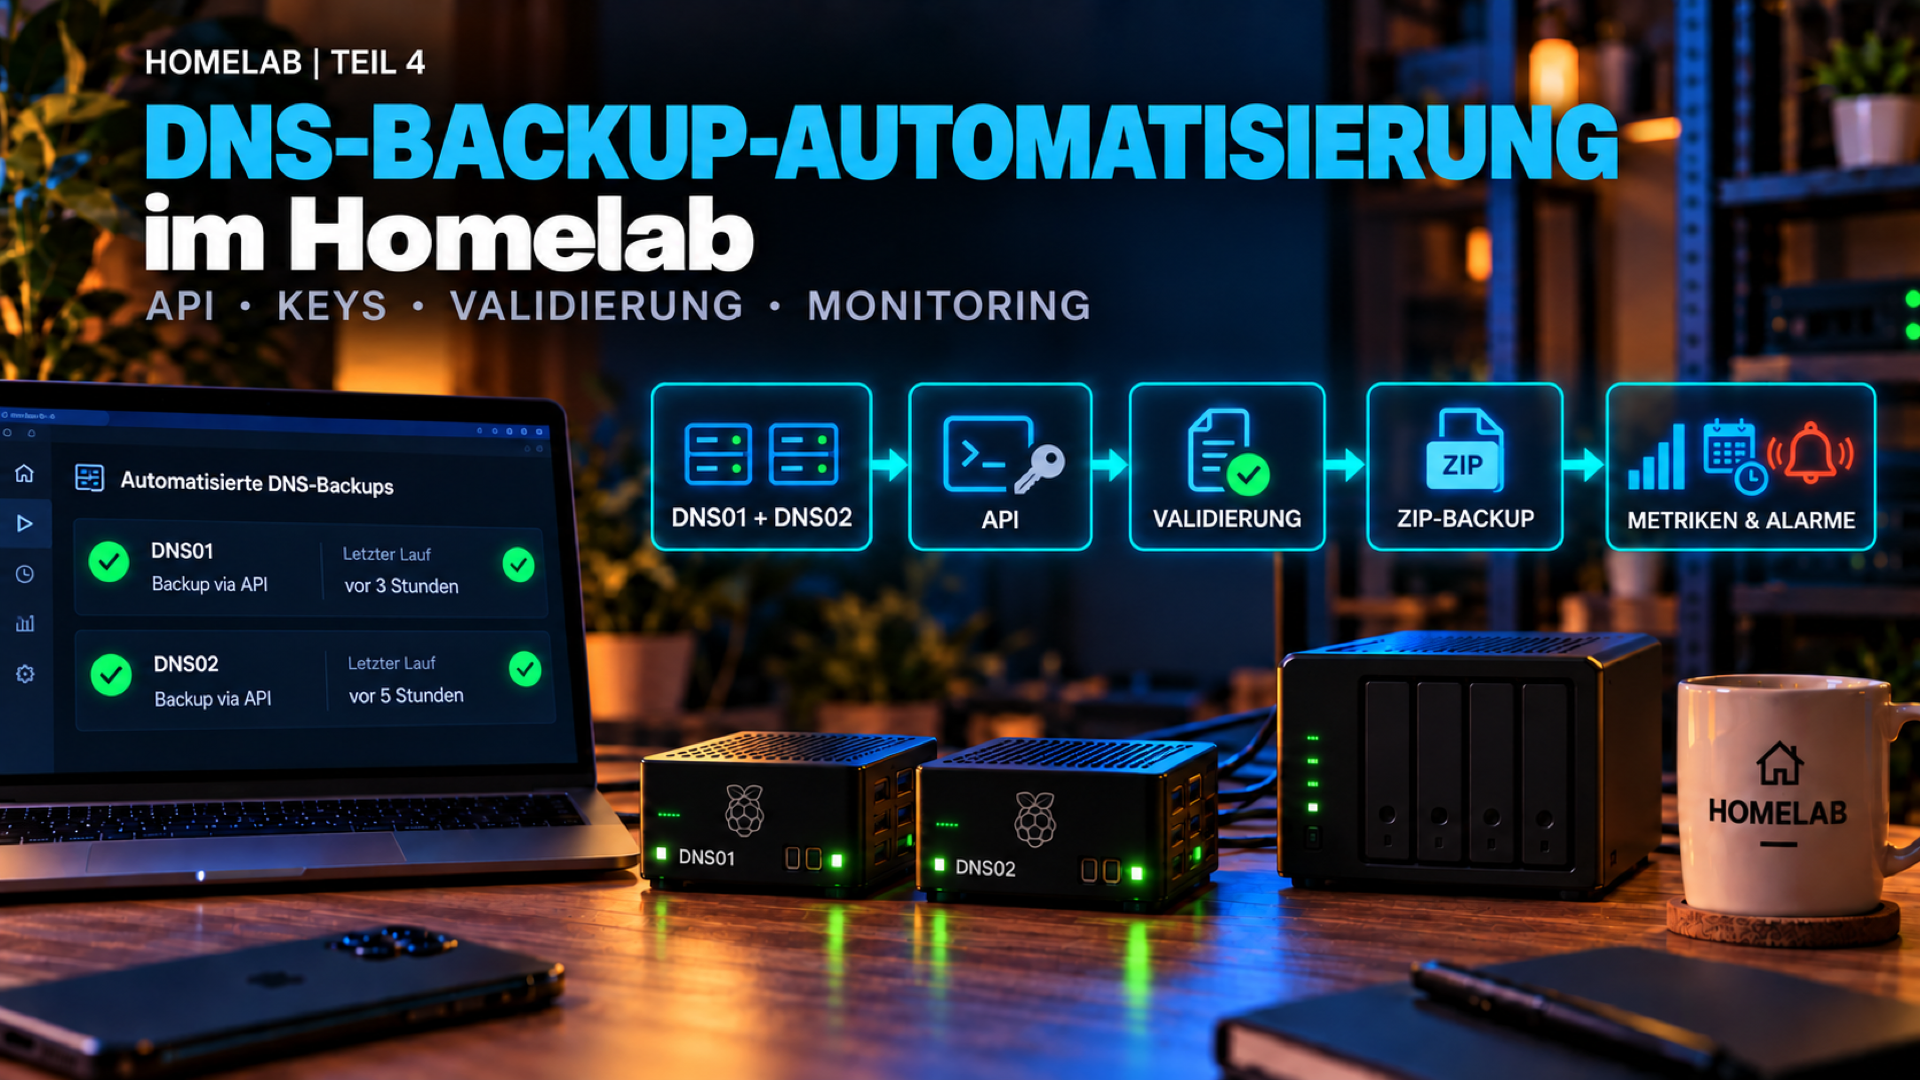
Im dritten Teil meiner Homelab-Serie ging es um Monitoring: Prometheus prüft meine beiden DNS-Server, Alertmanager verarbeitet die Alarme und ntfy bringt sie auf meine Geräte.
Der nächste kleine Baustein war eine technische Fingerübung mit praktischem Nutzen: Wie rufe ich die API von Technitium automatisiert auf? Wie übergebe ich dafür benötigte Keys, ohne sie fest in ein Skript zu schreiben? Und wie mache ich aus einem erfolgreichen Download einen nachvollziehbaren Prozess?
Das Ergebnis sichert inzwischen regelmäßig die Konfiguration von DNS01 und DNS02 auf mein QNAP und kann mir im Fehlerfall ganz konkret helfen. Eine vollständige produktive Backup-Strategie ist es trotzdem noch nicht. Dafür fehlen unter anderem ein isolierter Restore-Test, eine unabhängige zweite Kopie und die Trennung von weiteren Failure Domains.
Der praktische Nutzen und der Lernwert ergänzen sich dabei: Die Archive sind real verwendbar, während der Weg dorthin den kontrollierten Umgang mit APIs, Keys, Dateien und Metriken trainiert.
Die erste Version der Aufgabe klingt trivial:
Technitium-API aufrufen
        ↓
ZIP-Datei speichern
        ↓
fertig
Technisch lässt sich so schnell eine Datei erzeugen. Schon für eine saubere Übung bleiben aber einige wichtigere Fragen offen:
Ist die Datei vollständig übertragen?
Ist sie wirklich ein gültiges ZIP-Archiv?
Gehört sie zum erwarteten DNS-Server?
Wie viele gültige Sicherungen sind noch vorhanden?
Wie alt ist die letzte davon?
Würde ich bemerken, wenn der Prozess ausfällt?
Diese Fragen verschieben den Fokus von „API irgendwie aufrufen“ zu einer kleinen, überprüfbaren Automatisierung.
Zwei APIs, ein ausführender Host
Die Exporte werden nicht von den beiden Raspberry Pis selbst angestoßen. Stattdessen ruft mein QNAP die Technitium-API beider DNS-Server auf und speichert die Archive zentral.
Damit ist der Export zumindest vom jeweiligen DNS-Host getrennt. Ein Defekt am Pi oder an seiner SD-Karte nimmt nicht gleichzeitig die dortige Kopie mit. Das NAS bleibt allerdings eine gemeinsame Abhängigkeit und ist damit ausdrücklich noch keine unabhängige Backup-Ebene.
Der Ablauf sieht vereinfacht so aus:
DNS01 ── Technitium-API ──┐
                          ├── QNAP ── Validierung ── Backupbestand
DNS02 ── Technitium-API ──┘
Für die API-Aufrufe werden Zugangsdaten benötigt. Genau hier wurde aus dem kleinen Download-Skript eine interessante Übung im Umgang mit Keys.
Die Keys liegen nicht als Klartext im Skript. Das QNAP erhält sie erst zur Laufzeit über eine Maschinenidentität aus meinem Secret-Management. Das Skript verarbeitet sie nur für den jeweiligen Aufruf und schreibt sie weder in das Archiv noch in die Metrikdatei.
Mehr dazu folgt bewusst erst im fünften Teil der Serie. Dort geht es dann um Infisical, Machine Identities und die Frage, wie nicht-interaktive Systeme Secrets erhalten können, ohne dass sie dauerhaft in Skripten oder Konfigurationsdateien landen.
Ein API-Erfolg ist noch kein brauchbares Ergebnis
Ein erfolgreicher HTTP-Aufruf beweist noch nicht, dass die heruntergeladene Datei brauchbar ist. Eine abgebrochene Übertragung kann trotzdem eine Datei hinterlassen. Auch eine Fehlerseite mit Statuscode 200 wäre formal ein Download – aber kein Technitium-Archiv.
Deshalb landet jede neue Sicherung zunächst mit der Endung .part auf dem NAS.
Danach folgen mehrere Prüfungen:
erwarteter Dateiname?
        ↓
Mindestgröße erreicht?
        ↓
ZIP-Struktur vollständig und lesbar?
        ↓
atomare Umbenennung von .part nach .zip
Nur wenn alle Prüfungen erfolgreich sind, wird aus der temporären Datei ein reguläres Archiv.
Das ist ein kleines Detail mit großer Wirkung: Nachfolgende Schritte müssen nicht erraten, ob ein Archiv vollständig ist. Eine Datei mit .zip ist in diesem Bestand immer bereits technisch geprüft.
Für beide DNS-Server gelten getrennte Mindestgrößen. Das verhindert, dass ungewöhnlich kleine Dateien unbemerkt als Erfolg gewertet werden. Die eigentliche ZIP-Prüfung stellt zusätzlich sicher, dass das Archiv vollständig gelesen werden kann.
Ungültige oder unvollständige Dateien zählen nicht zum Bestand. Ebenso wenig werden liegengebliebene .part-Dateien als erfolgreicher Lauf betrachtet.
Retention mit praktischem Sicherheitsgurt
Die Archive werden 30 Tage aufbewahrt. Eine reine Altersregel hätte jedoch einen gefährlichen Nebeneffekt: Wenn die Erstellung längere Zeit unbemerkt ausfällt, könnte die Bereinigung nach und nach auch den letzten noch gültigen Bestand entfernen.
Deshalb kombiniert die Retention zwei Regeln:
Aufbewahrung: 30 Tage
Mindestbestand: 7 gültige Backups je DNS-Server
Gelöscht werden nur validierte ZIP-Dateien, die älter als 30 Tage sind – und auch nur dann, wenn danach mindestens sieben gültige Sicherungen des jeweiligen Servers erhalten bleiben.
Der Mindestbestand ist kein Ersatz für ein vollständiges Aufbewahrungskonzept. Er ist aber ein praktischer zusätzlicher Sicherheitsgurt und ein gutes Beispiel dafür, Löschlogik defensiv zu bauen.
Wichtig war mir außerdem ein Dry-Run. Damit zeigt das Skript zunächst nur, welche Dateien es entfernen würde. Erst nach dieser Kontrolle wird die tatsächliche Löschung aktiviert.
Getestet habe ich beides mit künstlich gealterten Testarchiven:
Dry-Run zeigt exakt die erwarteten Kandidaten       ✅
gültige Altbestände bleiben oberhalb des Minimums   ✅
Löschlauf entfernt nur die vorgesehenen Dateien     ✅
letzter gültiger Bestand bleibt geschützt           ✅
Damit ist die Löschlogik nicht nur konfiguriert, sondern praktisch geprüft. Das macht den Ablauf verlässlicher – aber noch nicht zu einer vollständigen Backup-Strategie.
Die Automatisierung liefert ihren eigenen Zustand
Ein täglich gestartetes Skript kann jahrelang in einer Aufgabenplanung stehen und trotzdem längst keine brauchbaren Ergebnisse mehr liefern. Deshalb wollte ich nicht nur den Download automatisieren, sondern auch seinen Zustand sichtbar machen.
Deshalb schreibt der Backup-Prozess nach jedem Lauf eigene Prometheus-Metriken. Ein Node Exporter auf dem QNAP liest sie über seinen Textfile Collector ein. Prometheus ruft diesen Exporter alle 30 Sekunden ab.
Pro DNS-Server werden unter anderem folgende Zustände sichtbar:
Backup gültig?             valid
Alter der letzten Datei    age_seconds
Größe der letzten Datei    size_bytes
Anzahl gültiger Archive    count
Zeitpunkt des letzten Laufs timestamp_seconds
Der Textfile Collector passt hier gut, weil das Skript keine eigene dauerhaft laufende Webanwendung werden muss. Es schreibt am Ende des Laufs lediglich eine kleine Metrikdatei. Der bereits überwachte Node Exporter übernimmt die Veröffentlichung.
Dabei gelten dieselben Regeln wie für das Archiv selbst: Die Metrikdatei wird zuerst vollständig erzeugt und anschließend atomar an ihre endgültige Stelle verschoben. Sie enthält keine Tokens oder andere Zugangsdaten.
Prometheus wertet daraus sechs Alarmregeln aus. Sie melden unter anderem:
keine Metrik vorhanden
letztes gültiges Backup zu alt
weniger als 7 gültige Archive vorhanden
letztes Archiv ungewöhnlich klein
Für das Alter gibt es zwei Eskalationsstufen: eine Warnung nach 26 Stunden und einen kritischen Alarm nach 36 Stunden. So entsteht zunächst ein sinnvoller Reaktionszeitraum, bevor aus einer Verzögerung ein ernstes Problem wird.
Auch die Mindestgröße wird pro DNS-Server bewertet, weil die realen Archivgrößen unterschiedlich sind. Ein einzelner globaler Grenzwert wäre hier entweder zu großzügig oder würde unnötige Fehlalarme produzieren.
Die vollständige Kette wurde getestet:
Backup-Skript
      ↓
Textfile Collector
      ↓
Node Exporter
      ↓
Prometheus-Regel
      ↓
Alertmanager
      ↓
ntfy-Meldung       ✅
Entwarnung         ✅
Erst dieser Test zeigt, dass nicht nur die Metrik existiert, sondern der Alarm im Ernstfall tatsächlich ankommt.
Was diese Fingerübung ausdrücklich nicht beweist
Trotz aller Prüfungen bleibt die wichtigste Grenze:
Die Integritätsprüfung eines ZIP-Archivs beweist nicht, dass sich daraus ein funktionierender DNS-Server wiederherstellen lässt.
Sie beweist, dass die Datei vollständig und strukturell lesbar ist. Sie beweist nicht, dass alle benötigten Einstellungen enthalten sind, der Import in einer frischen Umgebung gelingt oder der wiederhergestellte Server danach korrekte Antworten liefert.
Ein isolierter Restore-Test steht deshalb weiterhin als eigener Schritt auf meiner Liste. Ebenso fehlen noch eine zusätzliche Kopie außerhalb des NAS, ein dokumentierter Wiederanlauf und eine klare Aussage darüber, welche Wiederherstellungszeit ich überhaupt erreichen möchte.
Genau diese Trennung ist für mich eines der wichtigsten Learnings aus dem Aufbau:
Datei vorhanden     ≠ Backup gültig
ZIP gültig          ≠ Restore erfolgreich
Alarm konfiguriert  ≠ Meldung kommt an
Jede Stufe braucht ihren eigenen Nachweis.
Auch die zentrale Ablage bleibt eine Failure Domain. Archive, Node Exporter, Prometheus, Alertmanager und ntfy laufen in meinem Aufbau auf demselben NAS. Fällt es vollständig aus, fehlen sowohl die Dateien als auch der interne Alarmweg.
Für den aktuell bewusst begrenzten Rahmen ist das vertretbar. Bevor ich mich vollständig auf diese Sicherung verlasse, müssen diese Punkte jedoch gelöst und der Restore praktisch bewiesen sein.
Das wichtigste Learning aus diesem Schritt:
Eine gute Fingerübung darf ein echtes Problem lösen – solange klar bleibt, was sie bereits leistet und was noch fehlt.
Im Homelab lässt sich genau das mit überschaubarem Aufwand ausprobieren. Der technische Export ist nützlich und kann im Fehlerfall helfen. Gleichzeitig trainiert er Fähigkeiten, die weit über diesen einen Anwendungsfall hinausgehen: eine API kontrolliert ansprechen, Zugangsdaten zur Laufzeit beziehen, Ergebnisse validieren und den gesamten Ablauf messbar machen.
Im nächsten Teil geht es deshalb um die Zugangsdaten hinter dieser Automatisierung: Wie Maschinen mit Infisical Secrets zur Laufzeit erhalten, ohne dass Keys in Skripten, Konfigurationsdateien oder Archiven landen.